Python中正则表达式的处理与应用示例小结
前言
常被我们称作正则表达式裤的re库, 是借助一种形式化语法去描绘的文本匹配样式的库。经由这个库, 能够匹配特定字符串里头的某些内容, 像是拿它爬取网页内容时, 可依靠re库取得网页内容内的全部标签内容。
本篇将详细讲解re库的使用规则。
查找文本
比如说, 于一串字符串形式的文本里头, 咱们要去查找一个子字符串是不是在那个字符串当中, 并且返回它确切的位置索引, 这该如何去做呢?
import re
content = "My name is Li Yuanjing"
pattern = "name"
match = re.search(pattern, content)
print(match.start())
print(match.end())
运行之后,效果如下:
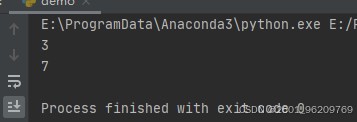
在这儿, 我们借助re.()函数去查找字符串是不是在那字符串之内。能够瞧见, 它返回了字符串于字符串里的起始索引以及结束索引的所在位置。
多重匹配
然而, 于平常的项目当中, 常常并非仅仅存有一个匹配结果, 或许偶尔会出现多个匹配结果。在这个时候, 我们得运用re.()函数来达成多重匹配。
import re
content = "asasssasasasaaasasasasssasasa"
pattern = "sa"
for match in re.findall(pattern, content):
    print(match)
运行之后,效果如下:
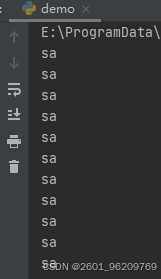
这里, 我们进行了11个的匹配。然而, 在这里返回的是match字符串, 并非如同上面一个所返回的那种Match示例。那么, 我当下想要获取所有多重匹配结果的索引位置, 该如何去做呢?
import re
content = "asasssasasasaaasasasasssasasa"
pattern = "sa"
for match in re.finditer(pattern, content):
    print(match.start(),match.end())
运行之后,效果如下:
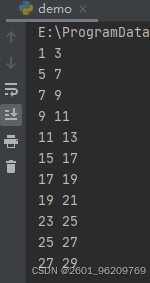
运行re.()函数所返回的, 是一个迭代器, 这个迭代器会生成Match实例。
元字符(锚定码)
犹如上面那样的一个字符串, 其中存在多个子字符串, 借助匹配必然会返回多个结果。此刻, 我们存有一个需求, 不论字符串里有多个匹配结果, 我们仅仅需要首个, 该如何去操作呢?
固然, 在此处我们依旧能够像上面那代码一样先寻觅全部, 接着选取首个便可。然而实际上我们能够借助元字符一步达成。首先, 我们先来瞧瞧元字符都有什么?
元字符含义
表示匹配任意一个字符(除了换行符)
表示从字符串开头开始匹配
表示从字符串末尾开始匹配
表示匹配某个字符匹配0到无穷次
表示匹配某个字符匹配1到无穷次
表示匹配某个字符匹配0或1次
{}
表示匹配某个字符匹配任意次
对于“为或”的意思, 去匹配其中任意一项, 在那里面, 除去了“-”、“\”以及“^”, 不存在其他特殊符号。
\A
字符串开头
\Z
字符串末尾
\b
单词开头或末尾的空串
\B
不在单词开头或末尾的空串
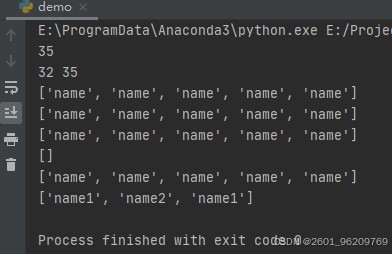
接下来, 我们要达成从终了方向进行匹配, 仅仅匹配出单单一个结果的操作。具体的代码是像下面这样呈现的:
import re
content = "name123name321name213name321name123"
print(len(content))
for match in re.finditer("123$", content):
    print(match.start(), match.end())
print(re.findall("name*", content))
print(re.findall("name+", content))
print(re.findall("name?", content))
print(re.findall("name{5}", content))
print(re.findall("name{1,5}", content))
print(re.findall("name[12]", content))
运行之后,效果如下:
转义码
有别于元字符, 我们能够借由转义码用以匹配特定的符号, 当中例如前之元字符仅能匹配后续存在多少个字符, 然而却无法区分数字或者字母等别的内容。接下来, 我们去瞧瞧正则表达式里常用的转义码。
转义码含义
\d
匹配数字
\D
匹配非数字
\s
匹配空白符(制表符,空格,换行等)
\S
匹配非空白符
\w
字母数字
\W
非字母数字
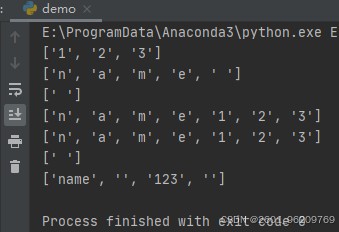
这里,我们来分别匹配看看效果,具体代码如下所示:
import re
content = "name 123"
print(re.findall("\d", content))
print(re.findall("\D", content))
print(re.findall("\s", content))
print(re.findall("\S", content))
print(re.findall("\w", content))
print(re.findall("\W", content))
#结合前面元字符,可以实现贪婪匹配
print(re.findall("\w*", content))
运行之后,效果如下:
()
换个时候, 我们并非要于字符串里找出某些规则的子集。而是得判定某些字符串是不是邮箱, 或者是不是电话之类。这时候, 就要使整个字符串和模式匹配, re库给出了()函数用来进行整个模式的匹配。
import re
content = "liyuanjinglyj@163.com"
pattern = "^[A-Za-z0-9\u4e00-\u9fa5]+@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)+$"
s = re.fullmatch(pattern, content)
if s is None:
    print("字符串不是邮箱")
else:
    print("字符串是邮箱")
编译表达式
虽说, 借由上面那种方式来做re库的运用能够达成字符串的匹配, 然而对于程序频繁用到的表达式来讲 的话, 将它们编译会更具效率。()函数能够把一个表达式字符串给转变为用于。具体代码如下:
import re
content = "liyuanjinglyj@163.com"
pattern = "^[A-Za-z0-9\u4e00-\u9fa5]+@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)+$"
regex = re.compile(pattern)
s = regex.search(content)
print(s[0])
组解析匹配
于上述邮箱匹配当中, 我们能够借由编译表达式去判定邮箱字符串是不是全然匹配。然而, 此刻倘若我们有一个更为庞大的需求, 也就是说要获取邮箱的域名, 以及用户名。很明显上述的知识仅仅能够匹配整个字符串, 或者分别创建两个来予以匹配。
这般常常极为耗费时间, 并且还提升了代码的冗余程度。故而, 咱们要谙熟re库的组解析匹配。具体代码示例为这样子:
import re
content = "liyuanjinglyj@163.com"
pattern = "^([A-Za-z0-9\u4e00-\u9fa5]+)@([a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)+)$"
regex = re.compile(pattern)
match = regex.search(content)
print(match.groups())
print("邮箱的用户名:", match.group(1))
print("邮箱的域名为:", match.group(2))
运行之后,效果如下:
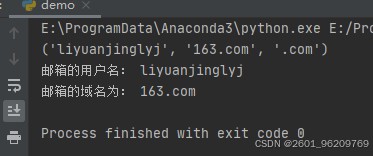
能够瞧见, 组匹配实际上也就是把进行匹配的规则字符串借由“()”规定成一组。然而, 要留意的是, 在这儿match.(0)并非是上面所呈现的首个字符串“”, 而是完整的字符串结果""。简单来讲, match.(0)是全部匹配的字符串, 从match.(1)着手才是运用()分组的解析内容。
搜索选项大小写无关匹配
基于上面所进行的学习, 我们都已然清楚, 只要于其中输入除去规则所运用到的字符之外者, 那么必然就须去匹配此字符, 然而实际上pile()函数存有另外一个参数, 对该参数予以设置能够将一定的规则忽略掉。举例而言, 于其中输入大写形式的字母“T”, 那么毫无疑义其小写形式便不会被匹配, 可是博主乃是想要去匹配大写与小写, 该如何是好呢?
凭借前文所具备的知识, 我们能够运用""或者开展操作。然而在学习了pile()函数的另外一项参数之后, 我们单单只需对该参数予以设置便可, 具体的代码如下述这样:
import re
content = "This text"
pattern = r"T\w+"
regex = re.compile(pattern, re.IGNORECASE)
match = regex.findall(content)
print(match)
运行之后,效果如下:
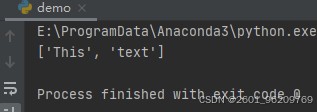
感兴趣的可以删除re.参数,看看是不是只有This。
其他匹配规则
把大小写匹配排除在外, 另外, pile()函数给出了别的参数, 情况如下表所呈现的那样:
参数含义
re.(re.I)
忽略大小写匹配
re.(re.M)
多行匹配(比如有末尾符号"$",它就会匹配每一行的末尾)
re.ASCII(re.A)
使\w, \W, \b, \B, \d, \D, \s以及\S实行ASCII, 只进行完整匹配的替代。这仅仅针对模式具备意义, 对于字节模式而言会被忽略。
re.(re.S)
让特殊字符‘.’与任意字符相匹配, 这里的任意字符包括换行符;若没有这个标志, 那么‘.’就只会匹配除换行符之外的任何内容。
re.(re.X)
为了让字符串可读性更高, 程序员用于标记注释的方式, 与代码注释规则一样, 比如在字符串中标注注释, 使用该参数进行匹配时, 这些注释会被忽略。
前后向断言
在网页爬虫里头, 要是我们想要匹配链接的标签, 通常都是成对地呈现出来才会去进行匹配。因此, 在这个时候, 唯有两个尖括号都现身或者都不现身的时候表达式才能够匹配。
前向断言语法为:(?=)
import re
contents = [
"aaa
到此这篇关于re:Python中正则表达式的处理与应用的文章就介绍到这了,更多相关Python正则表达式的处理与应用内容请搜索脚本之家以前的文章或继续浏览下面的相关文章希望大家以后多多支持脚本之家!
相关文章
 这篇文章主要为大家详细介绍了python实现大文本文件分割,具有一定的参考价值,感兴趣的小伙伴们可以参考一下2019-07-07
 Socket 又称套接字,是应用程序与网络传输层之间的接口,所有网络通信都基于 Socket,本文详细介绍了Python的socket模块,涵盖TCP和UDP协议的基本概念、常用API方法、高频配置选项及常见问题,有需要的可以了解下2026-06-06
 这篇文章主要介绍了如何在Python中用好短路机制,Python中的短路机制非常有用,跟很多其他编程语言中的短路机制作用类似,接下来让我们通过几个简单的例子总结Python中可用的几种短路机制,需要的朋友可以参考下2022-02-02
 在计算机中,不同的系统可能采用不同的字节序,NumPy提供的函数为我们提供了便捷的字节交换方法,通过本文的介绍,可以帮助我们更好地处理多字节类型的数据,感兴趣的可以了解一下2026-05-05
Python中os.listdir() 获取指定目录中的文件和子目录的列表
os.listdir()是Python os模块中的一个函数,用于获取指定目录中的文件和子目录的列表,本文主要介绍了Python中os.listdir() 获取指定目录中的文件和子目录的列表,感兴趣的可以了解一下2025-04-04 这篇文章主要介绍了Python 列表 sort()函数使用详解,本文通过实例代码给大家介绍的非常详细,对大家的学习或工作具有一定的参考借鉴价值,需要的朋友可以参考下2023-07-07
 这篇文章主要介绍了Python 数据类型的底层实现原理分析,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧2021-09-09
 这篇文章主要是作者写给Python2.7编程初学者的经验总结,侧重于包管理、代码调试等实际使用方面,需要的朋友可以参考下2015-04-04
 文章介绍了Python中可迭代对象的定义和常见类型,包括字符串、列表、元组、字典、集合、range对象、文件对象等,还介绍了不能直接遍历的类型,如数字、布尔值、None等,通过enumerate、zip和生成器等特殊方法,可以实现更复杂的遍历操作,感兴趣的朋友跟随小编一起看看吧2026-01-01
 ttk是Python中的一个模块,它提供了一组用于创建GUI界面的工具和控件,这些控件包括按钮、标签、文本框等,可以帮助开发者更方便地创建用户界面,这篇文章主要介绍了使用python实现下拉选择框和页签的方法,需要的朋友可以参考下2023-03-03
最新评论