Python代码实现轻松提取Word文档的正文与表格
Word 文档的内容不只有连续正文,还可能包含表格、标题、书签等结构。根据后续用途不同,需要分别提取为纯文本、结构化数据或指定区间内容:正文入检索库、表格进 CSV 供统计、标题做目录索引、书签取关键条款。手工逐份复制粘贴既慢又容易漏行,把这几类提取固化成脚本后,同一批文档可以分流产出不同产物。
用 Python 可以从 docx 里取到这几样东西:遍历 section.Paragraphs 拿正文文本,遍历 section.Tables 拿表格的行列数据,按 paragraph.StyleName 过滤出标题,按书签名用 BookmarksNavigator 取任意命名区间的内容。
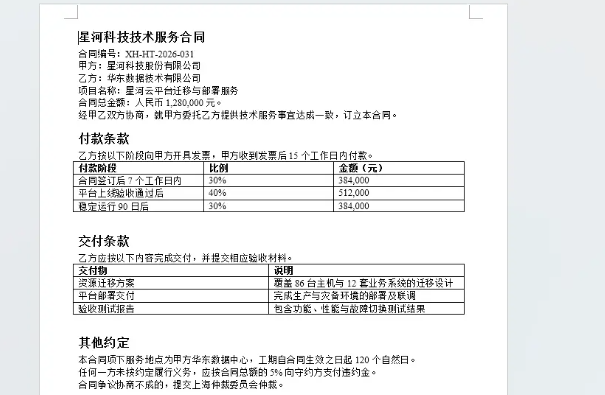
为了演示批量处理,本文使用三份结构相似的技术服务合同作为样例:每份含 4 个 Heading1 标题(合同标题、付款条款、交付条款、其他约定),标题下是正文段落;付款条款与交付条款两节里各有一张表格(付款计划 3 列、交付物明细 2 列),并各用一个同名书签把说明段落和表格包住。三份分别对应华东、华北、华南项目,付款阶段 3 到 4 条不等。文档实物放在文章目录,第 1 页样貌如下:
本文使用的方法需要用到 Free Spire.Doc for Python,可通过 pip 安装:
pip install spire.doc.free
Free 版对单份文档的段落数与表格数有上限,本文示例每份合同约 2 页、含 2 个表格,规模不受影响;超出上限的长文档需要商业版。
1. 提取正文文本
正文提取遍历每个节的顶层段落,取 paragraph.Text 写入文本文件。一段一行,段落顺序与文档一致。
from spire.doc import *
from spire.doc.common import *

def extractText(docxPath):
    doc = Document()
    doc.LoadFromFile(docxPath)
    lines = []
    for i in range(doc.Sections.Count):
        section = doc.Sections.get_Item(i)
        for j in range(section.Paragraphs.Count):
            para = section.Paragraphs.get_Item(j)
            lines.append(para.Text)
    doc.Close()
    return lines
对样例合同运行,得到 17 个段落、共 308 个字符,写入 正文_华东数据.txt:
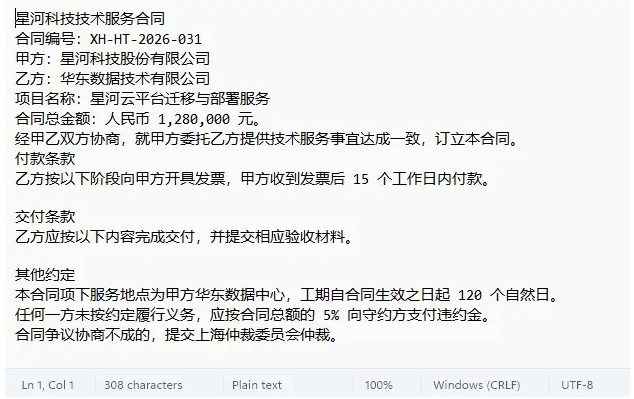
这里有一个对象模型上的边界:section.Paragraphs 只含节下的顶层段落,表格内部的段落不在其中。表格在 Word 文档里是 Body 的子对象,与段落平级,表格内段落归属表格而非节,所以不会出现在节的段落集合里。这意味着正文提取拿到的是文档顶层段落,表格内容不会重复出现——正文与表格是两类平级结构,需要分别遍历。如果要把全文压成一段纯文本喂给检索或大模型,可直接使用 doc.GetText() 获取包含表格在内的所有文本。
2. 提取所有表格
表格提取遍历 section.Tables,对每个表按行、按单元格取文本。单元格里的文本通过遍历 cell.Paragraphs 拼接,因为一个单元格可能含多个段落(单元格内换行),只取第一个段落会丢行。
def cellText(cell):
    parts = []
    for k in range(cell.Paragraphs.Count):
        parts.append(cell.Paragraphs.get_Item(k).Text)
    return " ".join(parts)
def extractTables(docxPath):
    doc = Document()
    doc.LoadFromFile(docxPath)
    tables = []
    for i in range(doc.Sections.Count):
        section = doc.Sections.get_Item(i)
        for t in range(section.Tables.Count):
            table = section.Tables[t]
            rows = []
            for r in range(table.Rows.Count):
                row = table.Rows[r]
                rows.append([cellText(row.Cells[c]) for c in range(row.Cells.Count)])
            tables.append(rows)
    doc.Close()
    return tables
# 写入CSV
outDir   = "output_csv"
os.makedirs(outDir, exist_ok=True)
for i, table in enumerate(extractTables(docxPath), 1):
    path = os.path.join(outDir, f"{os.path.splitext(os.path.basename(docxPath))[0]}_{i:02d}.csv")
    with open(path, "w", newline="", encoding="utf-8-sig") as f:
        csv.writer(f).writerows(table)
    print("已写入:", path)
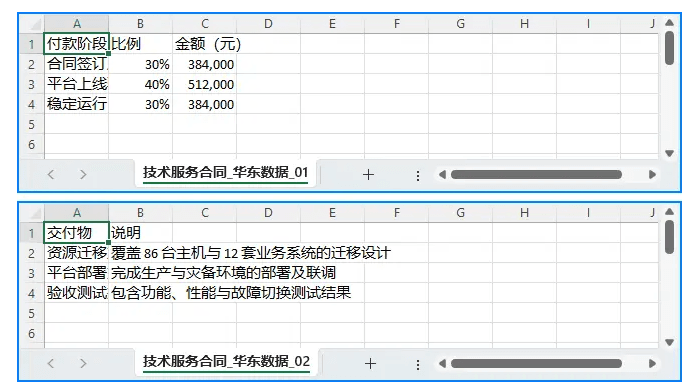
样例合同里有 2 个表格:付款计划 4 行 × 3 列、交付物明细 4 行 × 2 列。每个表写一份 csv,单元格之间用制表符分隔。选用制表符而非逗号,是因为说明字段里会出现顿号和逗号,用逗号做分隔符会破坏列边界。付款计划表内容:
3. 按样式提取标题
Word 用 Heading1、Heading2 等内置样式标记章节标题。按样式名过滤段落,可以把标题抽出来做目录索引,归档时附在每份文档前面方便定位。
def extractByStyle(docxPath, styleName):
    doc = Document()
    doc.LoadFromFile(docxPath)
    items = []
    for i in range(doc.Sections.Count):
        section = doc.Sections.get_Item(i)
        for j in range(section.Paragraphs.Count):
            para = section.Paragraphs.get_Item(j)
            if para.StyleName is not None and para.StyleName == styleName:
                items.append(para.Text)
    doc.Close()
    return items
以 Heading1 为样式名运行,得到 4 个标题:星河科技技术服务合同、付款条款、交付条款、其他约定。样式名是 Spire 内部对 Word 内置样式的命名,Heading1 对应 Word 的"标题 1"。如果文档用了自定义样式名,先用一次全量遍历打印所有 para.StyleName 确认实际取值,再按需过滤。
4. 按书签提取指定内容
书签提取解决的是"只取文档某一区间的内容"。文档里用书签标记一段范围,用 BookmarksNavigator 定位到书签后取内容。样例合同里付款条款、交付条款两节各用一个同名书签把说明段落和表格包住。
def extractBookmark(docxPath, bookmarkName):
    doc = Document()
    doc.LoadFromFile(docxPath)
    navigator = BookmarksNavigator(doc)
    navigator.MoveToBookmark(bookmarkName)
    textBodyPart = navigator.GetBookmarkContent()
    parts = []
    for i in range(textBodyPart.BodyItems.Count):
        item = textBodyPart.BodyItems.get_Item(i)
        if isinstance(item, Paragraph):
            para = item
            buf = []
            for j in range(para.ChildObjects.Count):
                child = para.ChildObjects.get_Item(j)
                if isinstance(child, TextRange):
                    buf.append(child.Text)
            parts.append("".join(buf))
        elif isinstance(item, Table):
            tbl = item
            lines = []
            for r in range(tbl.Rows.Count):
                row = tbl.Rows[r]
                lines.append("\t".join(cellText(row.Cells[c]) for c in range(row.Cells.Count)))
            parts.append("\n".join(lines))
    doc.Close()
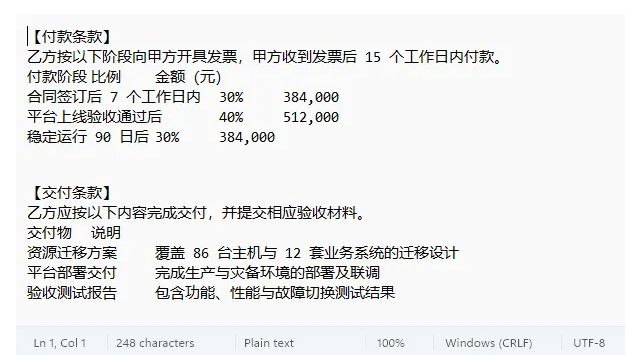
return "\n".join(parts)这里有一个只有实际跑过才会注意的细节:书签范围内含表格时,GetBookmarkContent 返回的 BodyItems 里既有 Paragraph 也有 Table 两种类型。只判断 Paragraph 会漏掉表格——付款条款书签在只取段落时拿到 34 个字(仅说明那一句),补上 Table 分支后拿到 120 个字,说明段落和整张付款计划表都在内。交付条款同理,从 23 字增到 110 字。书签提取要拿完整一个区间,必须对两种 BodyItem 分别处理。
付款条款书签的提取结果:
5. 批量处理多个 Word 文档
单份提取的函数放进外层循环,就能批量处理一批结构相同的文档。以合同归档为例:归档系统收到一批技术服务合同,需要把每份的付款计划抽出来汇总到一张总表,供预算核对与付款排期。遍历 3 份样例合同,各取第 1 个表格(付款计划)的数据行,合并写入一份 csv,同时累计付款金额。
FILES = [
    "技术服务合同_华东数据.docx",
    "技术服务合同_华北运维.docx",
    "技术服务合同_华南集成.docx",
]

summaryRows = []
totalAmount = 0
for name in FILES:
    tables = extractTables(os.path.join(ART_DIR, name))
    payTable = tables[0]
    for row in payTable[1:]:
        stage, ratio, amount = row[0], row[1], row[2]
        summaryRows.append([name, stage, ratio, amount])
        totalAmount += int(amount.replace(",", ""))
运行输出:
技术服务合同_华东数据.docx: 2 个表格,付款阶段 3 条
技术服务合同_华北运维.docx: 2 个表格,付款阶段 3 条
技术服务合同_华南集成.docx: 2 个表格,付款阶段 4 条
----------------------------------------
合同数: 3
表格总数: 6
付款记录总数: 10
付款金额合计: 3,680,000 元
汇总后的 汇总_付款计划.csv 共 10 条付款记录,3 份合同的付款阶段按文档顺序排列在同一张表里。这一节把前面四类提取串成一个完整流程:单份提取函数复用、外层套文件循环、同类表格汇到一张总表。换成报告、报价单、项目文档等结构相同的批量文件时,只需改文件列表和目标表格的索引。
6. 边界与适用场景
以上方法不仅适用于合同,也可用于报告、报价单、项目文档、归档材料等包含正文和表格的 Word 文件。只要文档用了内置标题样式和命名书签,四类提取就能直接套用。
样式名匹配区分大小写,Heading1 与 heading1 不等同。文档来源不同时样式命名可能不一致(有的模板用 Title、Subtitle),先打印全量 StyleName 再决定过滤值更稳妥。
表格提取拿到的是单元格纯文本,合并单元格按 Spire 的存储结构展开:横向合并的单元格在 row.Cells 里只出现一次,纵向合并的单元格在后续行对应位置仍占一个 Cell 对象,内容为空。需要还原合并语义时,结合 cell.CellFormat.VerticalMerge 与 cell.GridSpan 判断。
书签提取依赖文档里确实存在同名书签。若书签由他人手动添加、命名不统一,先用 document.Bookmarks 遍历打印所有书签名确认。
这套提取除 Spire.Doc 外没有其他依赖,正文入文本检索库、表格进 csv 供统计、标题做目录索引、书签取关键区间,四类产物可以从同一次文档遍历里分流输出,适合嵌在文档归档、知识库数据准备或 RAG 前处理的环节里。
到此这篇关于Python代码实现轻松提取Word文档的正文与表格的文章就介绍到这了,更多相关Python提取Word正文与表格内容请搜索脚本之家以前的文章或继续浏览下面的相关文章希望大家以后多多支持脚本之家!
相关文章
 Python是目前编程领域最受欢迎的语言,Python可用于许多领域,Web应用程序开发,自动化,数学建模,大数据应用程序等等,这篇文章主要给大家介绍了关于Python常见基础面试题及答案的相关资料,需要的朋友可以参考下2021-09-09
python中的tkinter库弹窗messagebox详解
这篇文章主要介绍了python中的tkinter库弹窗messagebox,包括消息提示框、消息警告框、错误消息框,通过代码给大家介绍的非常详细,需要的朋友可以参考下2021-06-06 这篇文章主要介绍了Python实现多线程抓取网页功能,结合具体实例形式详细分析了Python多线程编程的相关操作技巧与注意事项,并附带demo实例给出了多线程抓取网页的实现方法,需要的朋友可以参考下2017-06-06
 本文对于PyTorch中的各种维度变换的函数进行总结,包括reshape()、view()、resize_()、transpose()、permute()、squeeze()、unsqeeze()、expand()、repeat()函数的介绍和对比,感兴趣的可以了解一下2024-02-02
 这篇文章主要为大家详细介绍了python pygame控制物体移动,文中示例代码介绍的非常详细,具有一定的参考价值,感兴趣的小伙伴们可以参考一下2022-01-01
 今天给大家带来一篇爬虫小教程,很简单的几十行代码就可以实现了,爬取的目标是短视频,感兴趣的同学快来跟着小编往下看吧2021-11-11
 这篇文章主要介绍了Python定时任务APScheduler安装及使用解析,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友可以参考下2020-08-08
python中的实例方法、静态方法、类方法、类变量和实例变量浅析
这篇文章主要介绍了python中的实例方法、静态方法、类方法、类变量和实例变量浅析,需要的朋友可以参考下2014-04-04 今天小编就为大家分享一篇使用遗传算法求二元函数的最小值,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧2020-02-02
Python爬虫报错:requests.exceptions.ConnectionError原因与5种解决方法
写爬虫的时候,最常遇到的报错之一就是:requests.exceptions.ConnectionError,所以本文将带大家了解Python爬虫中ConnectionError的常见原因及解决方法,涵盖网络问题、代理设置及请求频率等多方面解决方案,需要的朋友可以参考下2026-06-06
最新评论