Python实现Word与TXT互转的完整代码
Word 文档承载了丰富的版式信息:字体、颜色、表格、图片、页眉页脚,适合作为最终交付的成品;但它也因此在很多自动化场景里显得"太重"。纯文本文件(.txt)则是另一种极端——它剥离了所有样式,只保留一行行文字,却正因为简单而能被任何程序读写、能直接进日志系统、能喂给自然语言处理脚本。把 Word 和 TXT 互相打通,往往就是连接"人写的精致文档"和"机器处理的数据"之间最短的桥。本文介绍如何用 Spire.Doc for Python,用最少的代码完成 Word 转 TXT 与 TXT 转 Word 两个方向的转换,并补充编码处理与批量处理的实战技巧。
为什么需要在 Word 与 TXT 之间互转
两个方向的转换解决的是完全不同的问题,理解各自的适用场景能帮你少走弯路:
- Word → TXT(提取纯内容):当你只关心文字本身、不关心样式时,比如做全文检索、关键词统计、把合同正文喂给大模型、或者生成可在任意终端查看的轻量副本,把 Word 另存为 TXT 是最直接的办法。
- TXT → Word(恢复可编辑性):当内容最初以纯文本形式存在——比如程序导出的日志、从网页复制下来的文字、同事发来的无格式备忘录——转成 Word 后才能排版、加标题、插入表格,成为一份像样的正式文档。
与手动"另存为"或在线转换工具相比,用脚本处理的好处是可复现、可批量、能嵌入更大的文档流水线,而且不依赖人工点击。
环境准备
本文使用 Spire.Doc for Python 完成 Word 与 TXT 之间的互转。它把转换逻辑直接封装在 Document 对象的 LoadFromFile 与 SaveToFile 方法中,指定不同的 FileFormat 即可在保存时自动完成格式切换。先通过 pip 安装:
pip install Spire.Doc
安装完成后,在脚本中导入所需模块即可开始:
from spire.doc import *
from spire.doc.common import *
FileFormat 等枚举来自 spire.doc.common,后续转换时直接引用即可。
将 Word 转换为 TXT
把 Word 变成纯文本,本质就是"换一种格式保存"——不需要任何额外处理,只要在 SaveToFile 的第二个参数里指定 FileFormat.Txt,Spire.Doc 就会在保存过程中把文档内容抽取成一行行纯文字,丢掉字体、颜色、表格线等所有样式信息。下面加载一份 .docx 并直接输出为 .txt:
from spire.doc import *
from spire.doc.common import *

inputFile = "./Data/Template_Docx_1.docx"
outputFile = "WordToTxt.txt"

# 创建 Word 文档对象
document = Document()
# 从磁盘加载待转换的 Word 文档
document.LoadFromFile(inputFile)
# 以 TXT 格式保存,完成 Word 到纯文本的转换
document.SaveToFile(outputFile, FileFormat.Txt)
document.Close()
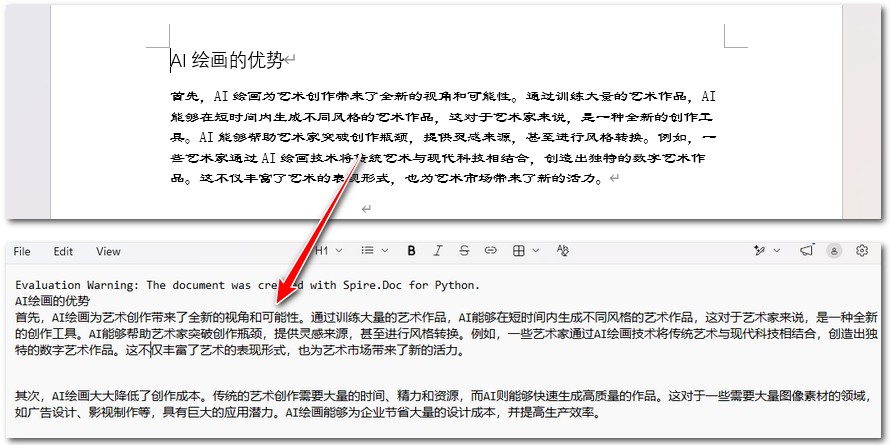
这段代码先 LoadFromFile 载入 Word,再调用 SaveToFile 并传入 FileFormat.Txt——引擎会遍历文档正文,把段落、标题文字按先后顺序拼成纯文本写出。转换结束后记得调用 Close() 释放文档资源,尤其在循环批量处理多份文件时,及时释放能避免内存占用过高。需要提醒的是:TXT 是一种"有损"格式,原本的加粗、表格、图片在结果里都不会保留,它只负责把"字"原原本本地拿出来。
将 TXT 转换为 Word
反过来,把纯文本变回 Word 同样是一条龙操作:Spire.Doc 能识别 .txt 扩展名,在 LoadFromFile 时按文本文件读入,随后的 SaveToFile 指定 FileFormat.Docx2013 即可输出成现代 .docx 文档。下面把一份 TXT 还原为可编辑的 Word:
from spire.doc import *
from spire.doc.common import *

inputFile = "./Data/Template_TxtFile.txt"
outputFile = "TxtToWord.docx"

# 创建 Word 文档对象
document = Document()
# 加载文本文件(按 .txt 扩展名自动识别为纯文本)
document.LoadFromFile(inputFile)
# 以 Docx2013 格式保存,完成 TXT 到 Word 的转换
document.SaveToFile(outputFile, FileFormat.Docx2013)
document.Close()
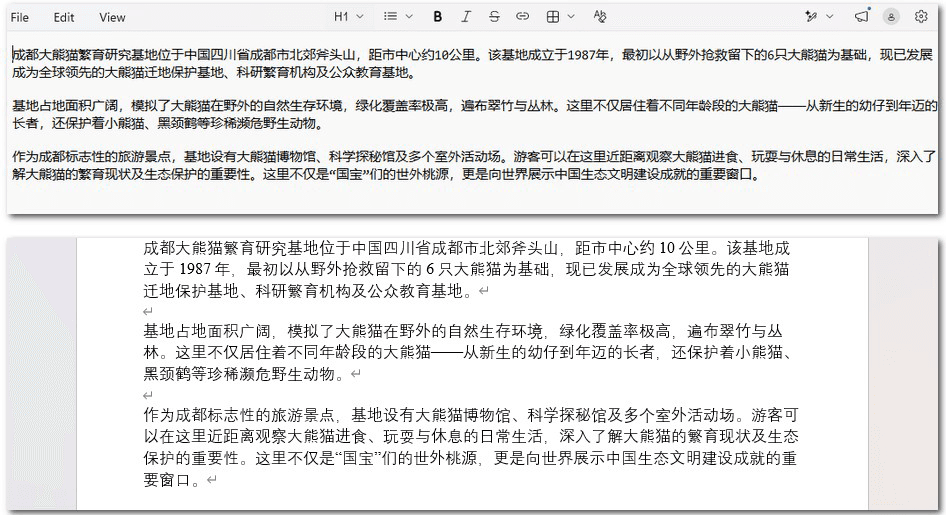
这里最值得注意的是 LoadFromFile 会自动根据扩展名判断文件类型,因此无需为"这是文本文件"额外声明。输出时选用 FileFormat.Docx2013,它对应 Office 2013 及之后版本的默认格式,兼容性最好。转换后的 Word 文档里,原文会按换行被拆成若干段落,但原本没有任何样式——它只是把"字"重新装回了 Word 的容器里,后续的字体、标题、表格都需要你自行添加。
处理带编码的文本文件
上面的 LoadFromFile 按扩展名读文本时,默认以常见编码(如 UTF-8 或系统默认编码)解析。如果你的 TXT 是 UTF-7、GBK 之类的特殊编码,直接 LoadFromFile 可能出现乱码。这时可以用 LoadText 方法,并显式传入 Encoding 来指定编码,再照常保存为 Word:
from spire.doc import *
from spire.doc.common import *

inputFile = "./Data/Sample_UTF-7.txt"
outputFile = "LoadTextWithEncoding.docx"

# 创建 Word 文档对象
document = Document()
# 按指定编码加载文本文件,避免乱码
document.LoadText(inputFile, Encoding.get_UTF7())
# 保存为 Word 文档
document.SaveToFile(outputFile, FileFormat.Docx2013)
document.Close()
LoadText 与 LoadFromFile 的区别在于前者把"读文本"这一步单独拎出来,并允许你控制编码细节——Encoding.get_UTF7() 只是其中一种,库里还提供了 get_UTF8()、get_Unicode() 等常见选项。当你从老系统、特定地区导出的文件里拿到 TXT 时,先用 LoadText 配对应编码读入,再 SaveToFile 成 Word,就能既保住文字不丢、又拿到可编辑的文档。
综合示例:批量互转一个文件夹
把上面的基础方法放进循环,就能一次性把某个目录里的多份文件批量转换。下面分别演示"把目录下所有 .docx 转成 .txt"和"把目录下所有 .txt 转成 .docx"两个方向的脚本,逻辑完全对称,只是 FileFormat 不同:
import os
from spire.doc import *
from spire.doc.common import *

work_dir = "./BatchFiles"
output_dir = "./Output"

# 确保输出目录存在
if not os.path.exists(output_dir):
    os.makedirs(output_dir)

# 方向一:Word -> TXT
for file_name in os.listdir(work_dir):
    if not file_name.lower().endswith(".docx"):
        continue
    document = Document()
    document.LoadFromFile(os.path.join(work_dir, file_name))
    out_path = os.path.join(output_dir, file_name.replace(".docx", ".txt"))
    document.SaveToFile(out_path, FileFormat.Txt)
    document.Close()
    print(f"已转 TXT:{file_name}")

# 方向二:TXT -> Word
for file_name in os.listdir(work_dir):
    if not file_name.lower().endswith(".txt"):
        continue
    document = Document()
    document.LoadFromFile(os.path.join(work_dir, file_name))
    out_path = os.path.join(output_dir, file_name.replace(".txt", ".docx"))
    document.SaveToFile(out_path, FileFormat.Docx2013)
    document.Close()
    print(f"已转 Word:{file_name}")

print("全部转换完成。")
这段脚本的关键点在于"用完即关":每次循环结束都调用 Close(),这样即使处理成百上千份文件,内存也始终处于可控范围。如果 TXT 来源编码不统一,只要把方向二里的 LoadFromFile 换成带 Encoding 的 LoadText 即可,整体结构不变。
实用技巧
- 看清"有损"与"无损":Word→TXT 会丢掉所有样式、表格、图片,只留文字;TXT→Word 得到的也是无样式段落,需要后续自己排版。不要把 TXT 当成 Word 的"备份额外版本"。
- 编码优先 UTF-8:生成或接收 TXT 时尽量统一成 UTF-8,能省掉大量乱码排查时间;遇到历史文件乱码,再用
LoadText+Encoding兜底。 - 优先输出 Docx2013:除非要明确兼容 Word 2003 之前的版本,否则 TXT→Word 一律用
FileFormat.Docx2013,体积更小、解析更可靠。 - 先验证单份再批量:批量前先用一两份有代表性的文件(含中文、含空行)试转,确认换行与段落切分符合预期,再跑全量。
- 大文件注意资源:页数很多的 Word 转换时占用内存较高,建议分批处理并在每份
Close()后稍作间隔,避免单次占用过大。
总结
本文介绍了如何使用 Python 和 Spire.Doc 在 Word 与 TXT 之间双向转换,核心内容如下:
- 使用
document.SaveToFile(outputFile, FileFormat.Txt)把 Word 文档抽取为纯文本 TXT - 使用
document.LoadFromFile(inputFile)加载 TXT 后,SaveToFile(outputFile, FileFormat.Docx2013)将其还原为可编辑的 Word 文档 - 当 TXT 编码特殊可能乱码时,改用
document.LoadText(inputFile, Encoding.get_UTF7())显式指定编码后再保存 - 将基础转换放入循环即可实现文件夹内文件的批量互转,并保持"用完即关"以控制内存
掌握这些方法后,你就能在"人写的精致 Word"和"机器好处理的纯文本"之间自由切换——无论是做内容抽取、日志归档,还是把零散文字整理成正式文档,都能用几行代码自动完成。实际项目中,建议先用单份文件确认换行与编码效果,再结合批量脚本一次性处理全量数据。
以上就是Python实现Word与TXT互转的完整代码的详细内容,更多关于Python Word与TXT互转的资料请关注脚本之家其它相关文章!
相关文章
 大家好,本篇文章主要讲的是用Python每天自动给女友免费发短信,感兴趣的同学赶快来看一看吧,对你有帮助的话记得收藏一下,方便下次浏览2021-12-12
 这篇文章主要介绍了Python之plt.bar绘制柱状图参数,具有很好的参考价值,希望对大家有所帮助,如有错误或未考虑完全的地方,望不吝赐教2023-09-09
最新Python爬虫从入门到精通:静态爬取+JS逆向+反爬绕过实战教程
本文从零基础出发,系统讲解Python爬虫的静态抓取、动态接口分析、JS逆向破解加密参数、反爬绕过(IP代理、Cookie维持、延时控制)及数据存储,包含完整可运行代码、抓包技巧、签名算法还原、常见报错解决方案,帮助读者真正实现从入门到精通2026-04-04 在本篇内容里小编给大家分享了关于python3爬虫怎样构建请求header的知识点,需要的朋友们学习下。2018-12-12
 在Python的网络爬虫中,网页解析是一项重要的技术。而在众多的网页解析库中,BeautifulSoup库凭借其简单易用而广受欢迎,在本篇文章中,我们将学习BeautifulSoup库的基本用法,有需要的朋友可以借鉴参考下,希望能够有所帮助,祝大家多多进步2023-08-08
 如果大家有做过web的自动化测试,相信对于selenium一定不陌生,测试人员经常使用它来进行自动化测试,下面这篇文章主要给大家介绍了关于selenium UI自动化实战的相关资料,需要的朋友可以参考下2021-12-12
 PyNaCI能够提供数字签名、密钥加密、公钥加密、哈希和消息身份验证、基于密码的密钥派生和密码散列功能,这篇文章主要介绍了python密码学库pynacl,感兴趣的朋友一起看看吧2022-05-05
 时间序列预测,是数据科学中最古老也最顽固的战场,这篇文章主要为大家详细介绍了Python如何使用Nixtla实现时间序列预测,文中的示例代码讲解详细,感兴趣的小伙伴可以了解下2026-06-06
 这篇文章主要为大家介绍了Tensorflow 2.1完成对MPG回归预测详解,有需要的朋友可以借鉴参考下,希望能够有所帮助,祝大家多多进步,早日升职加薪2022-11-11
 这篇文章主要介绍了Python函数对象与闭包,函数对象指的是函数可以被当做’数据’来处理,具体可以分为四个方面的使用,下文我们就来看看具体的这四种实用方法吧,需要的朋友可以参考一下2022-04-04
最新评论