MyBatis实现列表查询优化的实用技巧分享
订单列表只显示20条数据。查订单的SQL加了分页,客户表也有主键索引,日志里却连续出现20条查客户的语句。
问题往往藏在组装返回值的循环里:
var page = mapper.page(afterId);
var result = new ArrayList<Row>();
for (Order order : page) {
    String name = mapper.customerName(
        order.customerId());
    result.add(new Row(
        order.id(), displayName(name)));
}
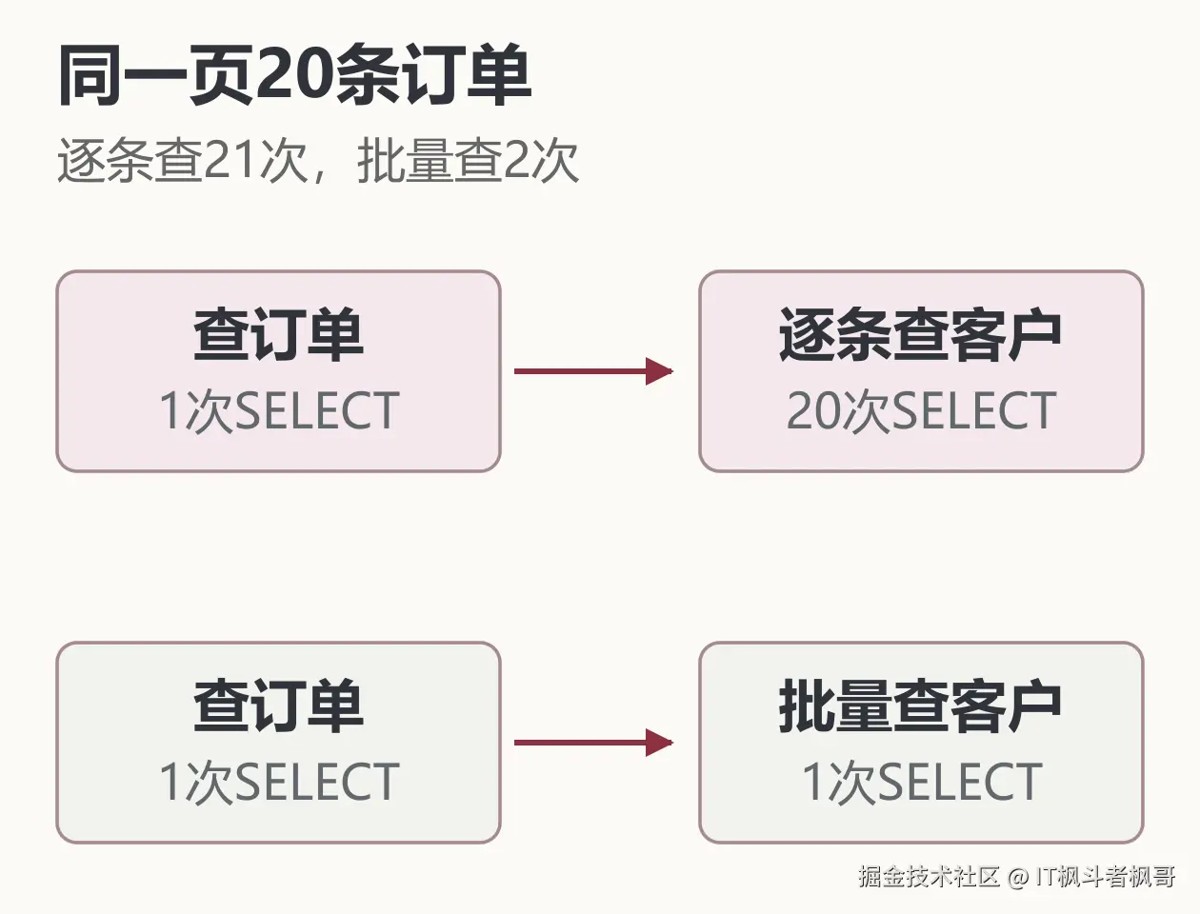
这段代码每拿到一个订单,就调用一次 customerName。当这页订单对应20个不同客户时,一次列表读取会执行21次查询:先查订单,再查20次客户。这就是常见的N+1查询:1次主查询,后面跟着N次关联查询。
改法是先收齐这页的客户ID,一次查回名称,再按订单顺序组装。 下面用MyBatis 3.5.19实际跑这两种写法,普通页的查询次数从21次降到了2次,返回的20条订单完全一致。
分页保留,把查客户移到循环外
订单查询继续只取当前页,不需要为了批量补名称,把所有订单都读出来。
SELECT id, customer_id
FROM orders
WHERE id > #{afterId}
ORDER BY id
LIMIT 20
拿到这一页后,收集客户ID并去重。接下来按这些ID查客户,用Map保存“客户ID → 客户名称”的对应关系。
服务层改成下面这样:
static List<Row> batch(
        OrderMapper mapper, int afterId) {
    List<Order> page = mapper.page(afterId);
    // 空页直接返回,不生成 IN ()。
    if (page.isEmpty()) return List.of();

    List<Integer> ids = page.stream()
        .map(Order::customerId).distinct().toList();
    Map<Integer, String> names = new HashMap<>();
    for (Customer customer : mapper.customers(ids)) {
        names.put(customer.id(), customer.name());
    }

    var result = new ArrayList<Row>();
    // 客户查询刻意倒序返回,仍按订单页的顺序组装。
    for (Order order : page) {
        result.add(new Row(order.id(),
            displayName(names.get(order.customerId()))));
    }
    return result;
}
mapper.customers(ids) 使用 foreach 生成 IN 条件,查询部分如下:
SELECT id, name FROM customers WHERE id IN
<foreach collection="ids" item="id"
         open="(" separator="," close=")">
    #{id}
</foreach>
ORDER BY id DESC
Mapper参数使用 @Param("ids") 命名。#{id} 绑定预处理参数,不把ID直接拼成SQL字符串。注解Mapper里的动态SQL需要放在 <script> 中,文末完整代码已经包含它。MyBatis动态SQL文档有对应用法。
这里故意让客户按ID倒序返回,订单仍按ID正序。这样可以检验:组装代码有没有错误地把两个列表按下标配对。
查询返回的先后顺序不能用来判断客户属于哪个订单,客户ID才可以。 Map查找用的是ID,最后的循环走的是原订单列表,所以客户查询顺序变化不会打乱页面。
少查19次,也不能少掉一条订单
我给程序准备了20条订单,其中第7条指向的客户资料不存在。两种方案都把它显示为“客户资料缺失”,保留这条订单。
实际输出的结果是:
普通页:逐条 21 次,批量 2 次
20 条订单的顺序与名称一致:true
第 7 条:Row[orderId=7, customerName=客户资料缺失]
如果批量查询后直接遍历客户列表生成页面行,这条订单就会消失。缺失关联数据的处理必须沿用原来的业务约定;这里采用占位名称,项目要求报错时就保留报错行为。
空页也检查了:订单查询没有结果,直接返回空列表,总共1次查询。不要继续向Mapper传空集合,生成一条没有有效 IN 条件的SQL。
还有两个容易漏掉的条件。原查询如果带租户或数据权限限制,批量查询也要保留;如果页面要求订单与客户资料来自同一快照,需要按业务要求处理事务和数据库隔离,不能把拆成两次读取默认当作一致性保证。
本例一页只有20个ID。把这个方法用到大批量数据时,需要根据数据库参数限制和执行计划决定是否分段,不能把整张表的ID一次塞进 IN。
开了一级缓存,为什么还值得改?
20条订单不一定每次都查21次。
我把第2条订单的客户改成第1条的客户,再跑逐条查询。同一个 SqlSession 内,第二次相同的客户查询命中了一级缓存,实际查询从21次变成了20次:
重复客户:逐条 20 次,批量 2 次
程序保留了 localCacheScope=SESSION,没有为了凑出21次而关闭缓存。两种方案各开一个新会话,避免前一组查询给后一组预热。
一级缓存能减少同一会话里的重复查询,但这页剩余的客户ID仍然不同,缓存不能把它们自动合成一条批量SQL。MyBatis配置文档说明了会话缓存的范围。
所以排查时要看实际执行的SQL,不能数一下Mapper调用,就把它当成数据库查询次数。下面的程序在 StatementHandler.query 上计数,缓存命中的查询不会经过这个位置;建表和准备数据的语句不计入结果。
这次改动收掉了循环里的逐条查询。至于线上接口能快多少,还要在相同数据和负载下测耗时,21次变2次不能直接换算成快了10倍。
能JOIN,为什么还要分两次查?
如果只是订单关联唯一客户、取一个名称,LEFT JOIN 完全可以作为候选,未必需要先查订单再查客户。选哪种写法,要结合现有Mapper职责、索引和执行计划。
这里保留两次查询,是为了演示如何改掉现有服务层里的循环查库。关联对象换成订单明细时,还要重新考虑分页:一笔订单有多条明细,连接后 LIMIT 20 限制的是结果行数,未必还能得到20笔订单。先确定订单页,再取关联数据,可以保留按订单分页的含义。
下次遇到列表接口查询多,先找到循环中的数据库调用:这批ID能否在进入循环前收齐?如果可以,通常就有机会把逐条读取合并起来。改完再用同一页数据核对查询次数、顺序和缺失记录,别只看日志变短了。
把代码跑一遍
下面是完整的Maven示例,只需要JDK 21和Maven,不需要另装数据库。我运行时用的是JDK 21.0.11、MyBatis 3.5.19、H2 2.3.232;H2使用内存库,启动时创建上述20条订单。
新建目录,放入这两个文件:
mybatis-query-lab/
├── pom.xml
└── src/main/java/demo/QueryLab.java
pom.xml:
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
  <modelVersion>4.0.0</modelVersion>
  <groupId>demo</groupId>
  <artifactId>mybatis-query-lab</artifactId>
  <version>1.0</version>
  <properties>
    <maven.compiler.release>21</maven.compiler.release>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
  </properties>
  <dependencies>
    <dependency>
      <groupId>org.mybatis</groupId>
      <artifactId>mybatis</artifactId>
      <version>3.5.19</version>
    </dependency>
    <dependency>
      <groupId>com.h2database</groupId>
      <artifactId>h2</artifactId>
      <version>2.3.232</version>
    </dependency>
  </dependencies>
  <build>
    <plugins>
      <plugin>
        <groupId>org.apache.maven.plugins</groupId>
        <artifactId>maven-compiler-plugin</artifactId>
        <version>3.13.0</version>
      </plugin>
      <plugin>
        <groupId>org.codehaus.mojo</groupId>
        <artifactId>exec-maven-plugin</artifactId>
        <version>3.5.0</version>
        <configuration>
          <mainClass>demo.QueryLab</mainClass>
        </configuration>
      </plugin>
    </plugins>
  </build>
</project>src/main/java/demo/QueryLab.java:
package demo;

import java.sql.Statement;
import java.util.*;
import org.apache.ibatis.annotations.*;
import org.apache.ibatis.datasource.unpooled.UnpooledDataSource;
import org.apache.ibatis.executor.statement.StatementHandler;
import org.apache.ibatis.mapping.Environment;
import org.apache.ibatis.plugin.*;
import org.apache.ibatis.session.*;
import org.apache.ibatis.transaction.jdbc.JdbcTransactionFactory;

public class QueryLab {
    public record Order(int id, int customerId) {}
    public record Customer(int id, String name) {}
    public record Row(int orderId, String customerName) {}

    public interface OrderMapper {
        @Select("""
            SELECT id, customer_id FROM orders
            WHERE id > #{afterId} ORDER BY id LIMIT 20
            """)
        @ConstructorArgs({
            @Arg(column = "id", javaType = int.class),
            @Arg(column = "customer_id", javaType = int.class)
        })
        List<Order> page(@Param("afterId") int afterId);

        @Select("SELECT name FROM customers WHERE id = #{id}")
        String customerName(@Param("id") int id);

        @Select("""
            <script>
            SELECT id, name FROM customers WHERE id IN
            <foreach collection="ids" item="id"
                     open="(" separator="," close=")">
                #{id}
            </foreach>
            ORDER BY id DESC
            </script>
            """)
        @ConstructorArgs({
            @Arg(column = "id", javaType = int.class),
            @Arg(column = "name", javaType = String.class)
        })
        List<Customer> customers(@Param("ids") List<Integer> ids);
    }

    // 本文程序单线程运行,只统计真正进入 StatementHandler 的查询。
    @Intercepts(@Signature(type = StatementHandler.class,
        method = "query", args = {Statement.class, ResultHandler.class}))
    public static class QueryCounter implements Interceptor {
        final List<String> sql = new ArrayList<>();
        public Object intercept(Invocation invocation) throws Throwable {
            var handler = (StatementHandler) invocation.getTarget();
            sql.add(handler.getBoundSql().getSql()
                .replaceAll("\\s+", " ").trim());
            return invocation.proceed();
        }
    }

    static List<Row> oneByOne(
            OrderMapper mapper, int afterId) {
        var page = mapper.page(afterId);
        var result = new ArrayList<Row>();
        for (Order order : page) {
            String name = mapper.customerName(
                order.customerId());
            result.add(new Row(
                order.id(), displayName(name)));
        }
        return result;
    }

    static List<Row> batch(
            OrderMapper mapper, int afterId) {
        List<Order> page = mapper.page(afterId);
        // 空页直接返回,不生成 IN ()。
        if (page.isEmpty()) return List.of();

        List<Integer> ids = page.stream()
            .map(Order::customerId).distinct().toList();
        Map<Integer, String> names = new HashMap<>();
        for (Customer customer : mapper.customers(ids)) {
            names.put(customer.id(), customer.name());
        }

        var result = new ArrayList<Row>();
        // 客户查询刻意倒序返回,仍按订单页的顺序组装。
        for (Order order : page) {
            result.add(new Row(order.id(),
                displayName(names.get(order.customerId()))));
        }
        return result;
    }

    static String displayName(String name) {
        return name == null ? "客户资料缺失" : name;
    }

    static List<Row> run(SqlSessionFactory factory, QueryCounter counter,
                         boolean useBatch, int afterId) {
        counter.sql.clear();
        // 两种方案各用一个新会话,避免前一组预热后一组的缓存。
        try (SqlSession session = factory.openSession()) {
            var mapper = session.getMapper(OrderMapper.class);
            return useBatch ? batch(mapper, afterId)
                            : oneByOne(mapper, afterId);
        }
    }

    static void require(boolean ok, String message) {
        if (!ok) throw new AssertionError(message);
    }

    public static void main(String[] args) throws Exception {
        var ds = new UnpooledDataSource(
            "org.h2.Driver", "jdbc:h2:mem:query_lab", "sa", "");
        // 保持此连接打开,让两个 SqlSession 使用同一份内存数据。
        try (var keeper = ds.getConnection();
             var setup = keeper.createStatement()) {
            setup.execute("CREATE TABLE orders "
                + "(id INT PRIMARY KEY, customer_id INT NOT NULL)");
            setup.execute("CREATE TABLE customers "
                + "(id INT PRIMARY KEY, name VARCHAR(60) NOT NULL)");
            for (int i = 1; i <= 20; i++) {
                setup.executeUpdate("INSERT INTO orders VALUES ("
                    + i + "," + (100 + i) + ")");
                // 故意缺少第 7 个客户,检查是否误删了订单。
                if (i != 7) setup.executeUpdate(
                    "INSERT INTO customers VALUES (" + (100 + i)
                    + ",'客户" + i + "')");
            }

            var env = new Environment("lab", new JdbcTransactionFactory(), ds);
            var config = new Configuration(env);
            config.setLocalCacheScope(LocalCacheScope.SESSION);
            var counter = new QueryCounter();
            config.addInterceptor(counter);
            config.addMapper(OrderMapper.class);
            var factory = new SqlSessionFactoryBuilder().build(config);

            var before = run(factory, counter, false, 0);
            int beforeCount = counter.sql.size();
            var after = run(factory, counter, true, 0);
            int afterCount = counter.sql.size();
            require(beforeCount == 21 && afterCount == 2, "查询数不符");
            require(before.equals(after) && after.size() == 20, "返回结果改变");
            for (int i = 0; i < after.size(); i++) {
                String expected = i == 6 ? "客户资料缺失" : "客户" + (i + 1);
                require(after.get(i).equals(new Row(i + 1, expected)),
                    "订单顺序或客户名称不符");
            }
            System.out.printf("普通页:逐条 %d 次,批量 %d 次%n",
                beforeCount, afterCount);
            System.out.println("20 条订单的顺序与名称一致:true");
            System.out.println("第 7 条:" + after.get(6));
            System.out.println("批量方案实际执行的 SQL:");
            counter.sql.forEach(System.out::println);

            var empty = run(factory, counter, true, 20);
            require(empty.isEmpty() && counter.sql.size() == 1, "空页多查");
            System.out.println("空页:1 次查询,0 条订单");

            setup.executeUpdate("UPDATE orders SET customer_id = 101 WHERE id = 2");
            var repeatedBefore = run(factory, counter, false, 0);
            int repeatedCount = counter.sql.size();
            var repeatedAfter = run(factory, counter, true, 0);
            require(repeatedBefore.equals(repeatedAfter)
                && repeatedAfter.size() == 20
                && repeatedAfter.get(1).customerName().equals("客户1")
                && counter.sql.size() == 2 && repeatedCount == 20,
                "重复客户场景不符");
            System.out.printf("重复客户:逐条 %d 次,批量 %d 次%n",
                repeatedCount, counter.sql.size());
        }
    }
}
在 pom.xml 所在目录运行:
mvn -q compile exec:java
除了前面的结果,程序还会打印批量方案实际执行的两条SQL,并检查空页、重复客户和缺失客户。它把客户查询刻意倒序;你可以去掉 ORDER BY id DESC 再运行,订单页仍应保持原顺序。
到此这篇关于MyBatis实现列表查询优化的实用技巧分享的文章就介绍到这了,更多相关MyBatis列表查询优化内容请搜索脚本之家以前的文章或继续浏览下面的相关文章希望大家以后多多支持脚本之家!
相关文章
 MyBatisPlus(简称MP)是基于MyBatis框架基础上开发的增强型工具,旨在简化开发、提高效率。本文将为大家详细介绍一下MyBatisPlus是使用,需要的可以参考一下2022-07-07
 本文介绍了三种在Java中实现定时任务的方法,并推荐使用Spring Boot注解方式,介绍了如何使用`@Scheduled`注解结合Cron表达式来设置定时任务,并提供了一个示例配置文件2025-03-03
Windows下Dubbo+Zookeeper实现分布式部署教程
本文介绍了如何使用Dubbo和Zookeeper搭建分布式服务,包括环境准备、项目结构、依赖引入、接口与服务实现、注解配置及服务调用流程,适合初学者参考和实践2025-10-10 这篇文章主要介绍了将Java项目打包成可执行的jar包,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友们下面随着小编来一起学习学习吧2020-06-06
 这篇文章主要为大家介绍了Java LockSupport的用法,具有一定的参考价值,感兴趣的小伙伴们可以参考一下,希望能够给你带来帮助,希望能够给你带来帮助2021-11-11
 这篇文章主要介绍了Java 运算符,Java 中的运算符与 C 语言基本一致。下面文章就围绕Java 中的运算符的相关资料展开内容,需要的朋友可以参考一下2021-11-11
MyBatis 教程完全指南:从入门配置到企业级动态 SQL 实战攻略
MyBatis 是一个优秀的持久层框架,它支持定制化 SQL、存储过程以及高级映射,MyBatis 避免了几乎所有的 JDBC 代码和手动设置参数以及获取结果集的工作,本文介绍MyBatis 教程完全指南:从入门配置到企业级动态SQL实战攻略,感兴趣的朋友一起看看吧2026-07-07 本文详细介绍了如何在Mybatis中使用typeHandler对特定字段进行加密处理,涵盖了从引入依赖、配置Mybatis,到实现typeHandler继承类和配置mapper层的详细步骤,为需要在项目中实现字段加密的开发者提供了参考和借鉴2024-09-09
 这篇文章主要介绍了J2SE与c#的几点比较,是看完马士兵老师的J2SE视频教程有感而写,需要的朋友可以参考下2014-08-08
Java中的 AtomicReference类概览及实现方案
在Java开发中,常常需要构建无锁的应用程序,以实现高性能的并发控制,本文给大家介绍Java中的AtomicReference类概览及实现方案,感兴趣的朋友跟随小编一起看看吧2025-09-09
最新评论