

Linux服务器磁盘空间占满排查与清理实操指南
测试环境说明
服务器:LuckVM 香港 CN2 节点(1 核 1G / 70GB NVMe) 系统:Debian 12 相关软件:Nginx 1.22、MySQL 8.0、Docker 24.0
前两天站点后台一直报 MySQL 写入失败,Nginx 也开始返回 500,登录服务器一查才发现磁盘直接 100% 占满,连日志都写不进去了。这种问题排查起来其实不难,但新手最容易踩的坑是「明明 rm 删了文件,df 看磁盘还是满的」,这篇文章就把完整的排查和清理流程记下来,从定位到根治一步步写清楚。
一、第一步:先确认到底是哪块盘满了
不要上来就乱删文件,先用 df 看清楚是哪块分区满了、还剩多少:
df -h
输出重点看 Use% 那一列,比如:
Filesystem Size Used Avail Use% Mounted on
/dev/vda1 70G 68G 1.2G 100% /
如果根分区是 100%,那基本就是系统盘被写满了。
一个经常被忽略的点:磁盘没满但服务写不了文件,很可能是 inode 用完了。inode 记录文件名和元数据,小文件(比如大量 session 文件、缓存碎文件)堆积会先把 inode 占满,空间却看着还有。所以还要补一条:
df -i
如果 IUse% 到了 100%,那就是小文件太多,处理思路和大文件占满完全不同(后面第六节会讲)。
把这次排查的结论画成图更直观。下面这张饼图是清理前根分区 70G 的占用分布(数据来自 du 逐层统计):
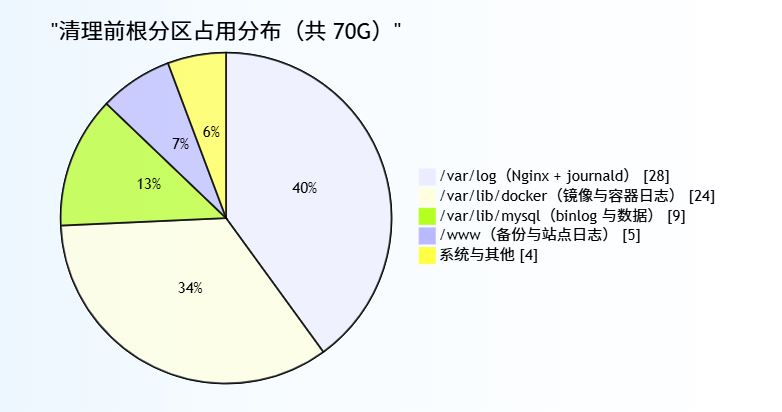
从图里能一眼看出,/var/log 和 /var/lib/docker 两个目录就吃掉了 52G,占了七成以上,这也是后面重点清理的对象。
二、第二步:用 du 逐层定位到底是哪个目录大
确定是根分区满了之后,从根目录逐层往下找,一层一层缩小范围:
# 看根目录下每个一级目录的大小,从大到小排序取前20个
du -h --max-depth=1 / 2>/dev/null | sort -rh | head -20
找到最大的那个目录(比如 /var),再继续往下一层挖:
du -h --max-depth=1 /var 2>/dev/null | sort -rh | head -20
du -h --max-depth=1 /var/log 2>/dev/null | sort -rh | head -20
这样几层下来,基本就能锁定是哪个目录在吃盘。我用这套方法很快就定位到了 /var/log 和 /var/lib/docker 两个目录,占了 50 多个 G。
三、第三步:用 ncdu 可视化找大文件(最直观)
如果不想一层层敲 du,直接装个 ncdu,交互式界面,按目录大小排序,方向键就能翻,找大文件特别快:
apt update && apt install -y ncdu
ncdu /
进去之后按 d 可以直接删除选中项,比手动敲 rm 安全(会二次确认)。⚠️ ncdu 扫整个根目录会有点慢,磁盘 I/O 吃紧时先扫 /var 这种重点目录:
ncdu /var
四、第四步:用 find 精确定位超过指定大小的大文件
如果你只想揪出「单个大文件」,用 find 按体积过滤最快:
# 找出全盘大于 500M 的文件,按大小列出
find / -type f -size +500M -exec ls -lh {} \; 2>/dev/null | sort -k5 -rh
排查大文件时记得排除 /proc、/sys 这类虚拟文件系统,不然会报一堆权限错误,上面加了 2>/dev/null 就是屏蔽这些报错。
五、大坑:文件 rm 删了,df 看磁盘还是满的
这是我这次踩的最大的一个坑。用 du 看目录明明没多大,du 加起来远小于 df 显示的已用空间,那多半是有进程还在持有已经被删除的文件。
原理是:Linux 里 rm 只是把文件的目录项删掉,如果还有进程(比如正在写日志的 Nginx、MySQL)持有这个文件的句柄,文件数据要等进程关闭句柄后才真正释放。这时候表现在磁盘一直满着,但你又找不到这个文件。
用 lsof 揪出来:
# 找出所有被删除但还被进程占用的文件
lsof -nP 2>/dev/null | grep '(deleted)'
输出里可以看到是哪个进程、占了多大的已删除文件。处理方式有两种:
- 最稳妥:重启持有该文件的进程,句柄一释放空间就回来了:
systemctl restart nginx
systemctl restart mysql
- 不想重启服务:直接清空该文件描述符(慎用,操作前务必确认 PID 和 fd 号没写错):
# 假设 lsof 显示 PID 是 1234,fd 是 5
truncate -s 0 /proc/1234/fd/5
我这次是 MySQL 的慢查询日志被 rm 之后没重启进程,磁盘一直不释放,重启完 MySQL 空间立刻回来了 20G。
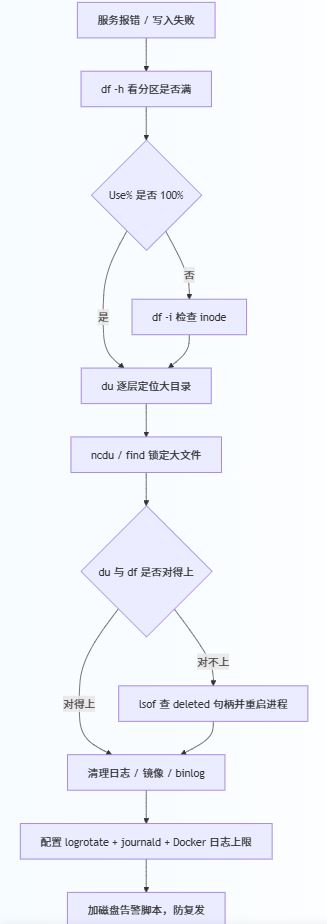
整个排查到根治的流程可以概括成下面这张图,按顺序走基本不会漏:
六、常见的几个「吃盘大户」和对应清理方法
1. Nginx 访问日志和错误日志
访问量大的站点,access.log 几天就能涨到几个 G:
# 查看日志大小
ls -lh /var/log/nginx/
# 直接清空(比 rm 好,不会丢句柄)
truncate -s 0 /var/log/nginx/access.log
truncate -s 0 /var/log/nginx/error.log
⚠️ 对正在被 Nginx 写入的日志,用 truncate -s 0 而不是 rm,rm 之后不 reload 不会释放空间。
2. systemd journal 日志
systemd 的 journald 默认可能占用几百 MB 到几个 GB:
# 查看占用
journalctl --disk-usage
# 只保留最近 3 天
journalctl --vacuum-time=3d
# 或限制总大小到 500M
journalctl --vacuum-size=500M
想长期限制,可以改配置文件(后面第七节)。
3. Docker 的镜像、容器日志
Docker 是隐性吃盘大户,镜像层、容器写出的日志都能堆很久:
# 看 Docker 各部分的磁盘占用
docker system df
# 清理无用镜像、停止的容器、构建缓存、未使用的网络
docker system prune -a
注意 docker system prune -a 会删掉所有未使用镜像,生产环境执行前先 docker images 确认一下别误删。
4. MySQL 的 binlog
MySQL 的二进制日志(binlog)是主从复制和恢复用的,如果没配过期清理,会一直累积:
# 进 MySQL 查看 binlog 列表
mysql -uroot -p
SHOW BINARY LOGS;
-- 清理指定时间之前的 binlog
PURGE BINARY LOGS BEFORE '2026-10-01 00:00:00';
MySQL 8.0.11 之后推荐直接在配置里设过期时间:
[mysqld]
binlog_expire_logs_seconds = 604800
5. 面板和备份残留
如果用了宝塔之类的面板,/www/backup、/www/wwwlogs 目录很容易忽视,里面堆着历史备份和站点日志,定期手动清一下:
du -h --max-depth=1 /www 2>/dev/null | sort -rh
6. /tmp 临时目录和下载残留
/tmp 里的临时文件、之前 wget/curl 下的大文件包,也经常被忘掉:
# 清理 7 天没动过的临时文件
find /tmp -type f -atime +7 -delete
七、从根上治理:配置日志轮转和容量限制
清完只是一时爽,不配好规则过几天又满。下面几个配置能一劳永逸。
1. 配 logrotate 自动切割 Nginx 日志
编辑 /etc/logrotate.d/nginx:
/var/log/nginx/*.log {
daily
rotate 7
missingok
compress
delaycompress
notifempty
create 0640 www-data adm
sharedscripts
postrotate
[ -f /var/run/nginx.pid ] && kill -USR1 $(cat /var/run/nginx.pid)
endscript
}
含义是每天切割一次、保留 7 份、压缩旧日志,配合 kill -USR1 让 Nginx 重新打开日志文件,不会丢句柄。
2. 限制 journald 日志上限
编辑 /etc/systemd/journald.conf:
[Journal]
SystemMaxUse=500M
SystemMaxFileSize=100M
MaxRetentionSec=7day
改完重启:
systemctl restart systemd-journald
3. 限制 Docker 容器日志大小
这个一定要配,不然一个写日志的容器跑几天就能把磁盘顶满。编辑 /etc/docker/daemon.json:
{
"log-driver": "json-file",
"log-opts": {
"max-size": "100m",
"max-file": "3"
}
}
改完重启 Docker(注意会影响运行中的容器,建议维护窗口操作):
systemctl restart docker
⚠️ 该限制只对新创建的容器生效,已经存在的容器需要重建才会应用。
4. 加一个磁盘告警脚本
再补一个定时检查,磁盘超过 85% 就发通知,别等满了才发现。简单写个脚本,配合 crontab 每小时跑一次:
#!/bin/bash
# /root/check_disk.sh
THRESHOLD=85
USED=$(df -h / | awk 'NR==2 {print $5}' | tr -d '%')
if [ "$USED" -ge "$THRESHOLD" ]; then
echo "磁盘使用率已达 ${USED}%,请及时清理" | mail -s "磁盘告警" your@email.com
fi
chmod +x /root/check_disk.sh # 每小时检查一次 crontab -e # 添加一行: 0 * * * * /root/check_disk.sh
八、踩坑总结
- 先
df分清是空间满还是 inode 满,两者处理思路完全不同,别一上来就删大文件 du和df对不上,先查lsof | grep deleted,八成是被删除但没释放句柄的文件,重启对应进程即可- 正在被进程写入的日志用
truncate -s 0,别用rm,rm不 reload 不释放空间 - Docker 的日志上限一定要提前配,
daemon.json里加上max-size,能省很多事 - MySQL binlog 记得设过期时间,尤其是开了主从或者频繁写入的库
- 清理只是应急,轮转和告警才是根治,
logrotate+journald限制 + Docker 日志限制 + 定时告警,配好之后基本不会再被磁盘问题半夜叫起来 - 动态扩容前先清日志,很多「磁盘不够用」其实清一轮日志就回来了,不急着加盘
这套流程我在自己的生产环境上跑过好几轮了,从定位到清理到根治,按顺序来基本都能解决。有更省事的清理脚本或者别的吃盘大户,欢迎在评论区交流。
以上就是Linux服务器磁盘空间占满排查与清理实操指南的详细内容,更多关于Linux服务器磁盘空间占满排查与清理的资料请关注脚本之家其它相关文章!
相关文章
 为了更好地监测您的Linux系统的硬件健康状况,如CPU与硬盘温度、风扇转速等关键指标,采用lm_sensors与hddtemp这两款强大工具是明智之选,以下是关于这些工具的详尽指南,包括它们的功能介绍、安装步骤以及如何配置,需要的朋友可以参考下2025-02-02

linux No space left on device由索引节点(inode)爆满引发500问题
这篇文章主要介绍了linux No space left on device由索引节点(inode)爆满引发500问题,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友们下面随着小编来一起学习学习吧2019-11-11 这篇文章主要介绍了Ubuntu部署python3.5的开发和运行环境,具有一定的参考价值,感兴趣的小伙伴们可以参考一下。2017-01-01
 在Linux服务器中创建子账户的步骤包括:打开终端,使用root用户或sudo权限登录,使用`adduser`命令创建新用户并设置密码,选择是否将新用户添加到sudo组,以及如何以新用户身份登录和退出2026-01-01
 这篇文章主要介绍了Linux nl命令的使用方法,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友们下面随着小编来一起学习学习吧2020-02-02

详解Centos中mount命令挂载windows7共享目录
本篇文章主要介绍了Centos中mount命令挂载windows7共享目录,具有一定的参考价值,感兴趣的小伙伴们可以参考一下。2017-03-03 本篇文章主要介绍了详解linux驱动编写(入门),小编觉得挺不错的,现在分享给大家,也给大家做个参考。一起跟随小编过来看看吧2018-04-04
 这篇文章主要介绍了Linux下非交互式提权的相关资料,文中介绍的非常详细,对大家具有一定的参考价值,需要的朋友们下面来一起看看吧。2017-03-03
 很多人和Sudu一样都想使用监控宝去监控自己的linux服务器,但是因为安装snmp存在一些问题导致无法成功设置snmp的设置。2010-12-12
 Linux系统中修改主机名称可以临时或永久进行,临时修改仅在当前会话有效,永久修改则需编辑系统配置文件,使用systemd的系统可通过hostnamectl命令更新主机名,同时更新/etc/hosts文件确保一致性2024-11-11
最新评论