

Linux服务器内核参数优化实践教学:哪些该改,哪些别照抄
前几天翻到一份企业部署文档,标题叫「操作系统参数优化」。
34 行内核参数,加 10 行用户资源限制,排得整整齐齐:连接队列 65535、文件数 100 万、内存锁上限全是不限量。
第一眼的感觉是:这文档真细。
第二眼的感觉是:这里面有一半,改了跟没改一样;还有几行,抄进去会出事。
我把这 44 行挨个对着内核默认值比了一遍,结果分三堆:
11 行是原地踏步,5 行是给自己挖坑,剩下 18 行方向没错,但数得按自己的机器重算。
这不是那份文档写得差。它写得很认真,还专门标了「为物理内存的 5%,请根据实际情况修改」。
问题在于,参数清单这种东西天生适合「抄」,不适合「想」。而这份清单里,恰恰有几行是抄了就出问题的。
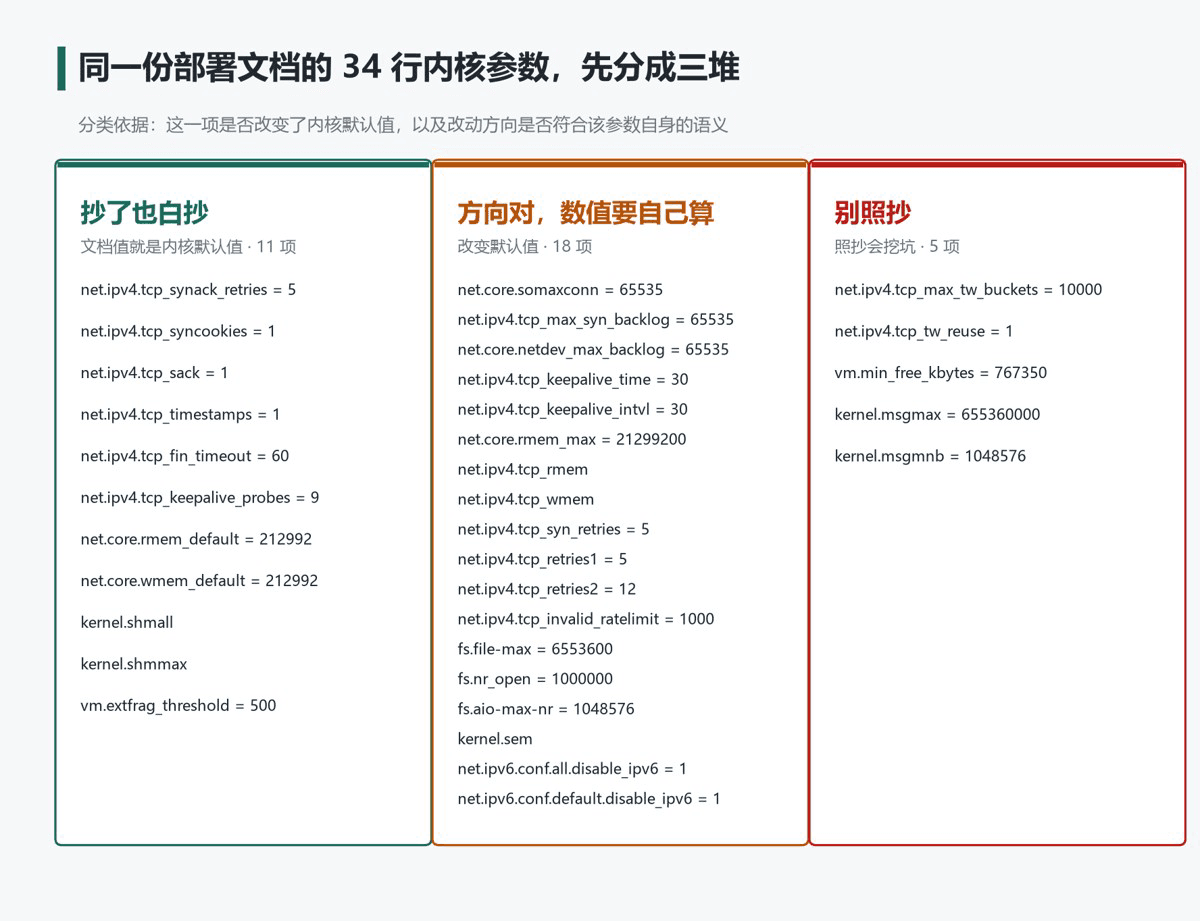
分堆之前,先给三个判断标准,谁都能用:
- 这个值,比你机器上现在的值大,还是小?
- 变大变小,是这项参数本来该走的方向吗?
- 它旁边那个配套的数,跟它对得上吗?
一、抄了也白抄的 11 行
先把最无害的一堆放出来:
| 参数 | 文档值 | 内核默认 |
|---|---|---|
tcp_synack_retries | 5 | 5 |
tcp_syncookies | 1 | 1 |
tcp_sack | 1 | 1 |
tcp_timestamps | 1 | 1 |
tcp_fin_timeout | 60 | 60 |
tcp_keepalive_probes | 9 | 9 |
rmem_default / wmem_default | 212992 | 212992 |
vm.extfrag_threshold | 500 | 500 |
这几行抄进配置文件,sysctl -p 跑得通,值也没变。等于原地踏步。
还有两个容易看走眼的:kernel.shmall 和 kernel.shmmax。文档给的是天文数字级的量,而 64 位系统上 shmmax 默认就是「不限制」。数写得很大,可它从来没有真正卡住过谁。
白抄不算错,甚至有个好处:把默认值显式写出来,后来人能看见现状。
真正的坏处是:配置文件越堆越长,长到没人敢删。
以后有人问「这行为什么这么配」,答案只有一句「文档抄的」。这句话一出现,参数就再也动不了了。
二、方向对,数值得自己算的 18 行
这一堆最多,也最容易白忙一场:值确实变了,线上却没什么感觉。
队列:三个 backlog,管的是三个地方
部署文档连着三行 65535,名字长得像,管的位置差得远。可以想成一个办事大厅:
netdev_max_backlog:大门口的取号机,网卡收进来的包先在这排队。tcp_max_syn_backlog:登记处,正在核对身份、手续还没办完的人。somaxconn:办完手续、坐着等窗口叫号的等候区。
三行一起调到 65535,改的只是「大厅最多能装多少人」,没改「窗口一次叫几个号」。
那个数在应用手里:程序调用 listen() 时自己申请的排队长度。
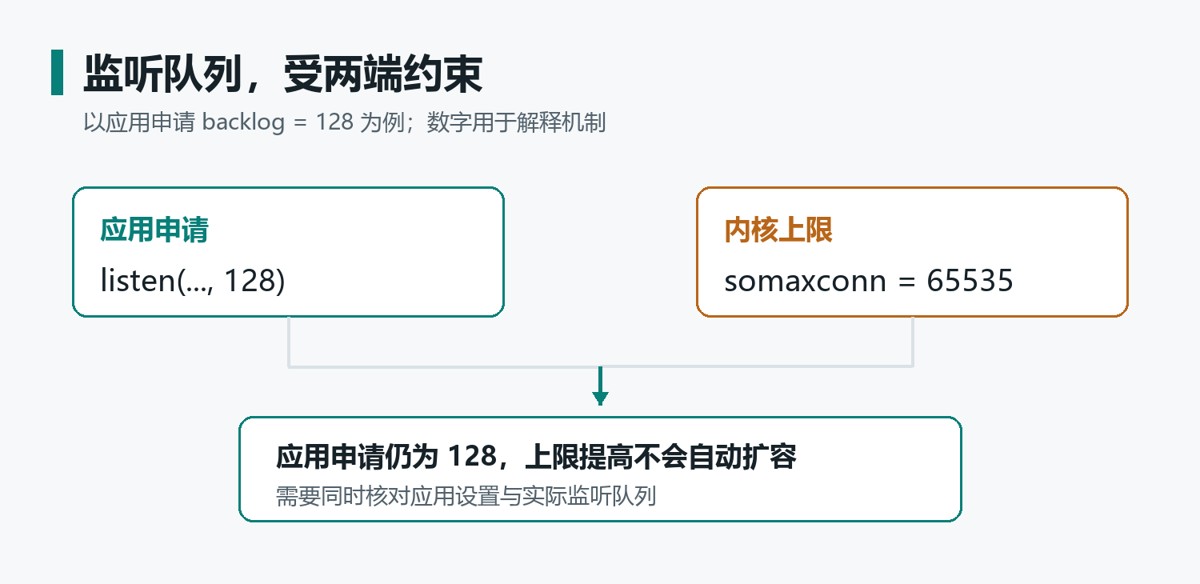
应用只申请 128,内核允许 65535,真正生效的还是 128。就像大厅能站一万人,门口保安只放 128 个进来。
怎么查:ss -lnt 里的 Recv-Q 是现在排了多少人,Send-Q 是这条通道实际放行多少。
低峰时看到一个 0 说明不了什么,得在高峰前后各取一次,再看 nstat -az TcpExtListenOverflows TcpExtListenDrops 的增量。
队伍加长能接住突发,但如果应用一直处理不过来,队伍变长只是让用户多等一会儿。判断看错误率和尾延迟,不看队列数字好不好看。
超时:30 秒不是「断线时间」
net.ipv4.tcp_keepalive_time = 30
net.ipv4.tcp_keepalive_intvl = 30
net.ipv4.tcp_keepalive_probes = 9
这三行最容易被读成「30 秒没动静就断开」。不是。
真实过程是:连接空闲 30 秒后,内核开始问对方「你还在吗」;对方不回应,每隔 30 秒再问一次,问满 9 次才放弃。
按最坏情况算,是 30 秒空闲,加 9 次 × 30 秒,接近 5 分钟。
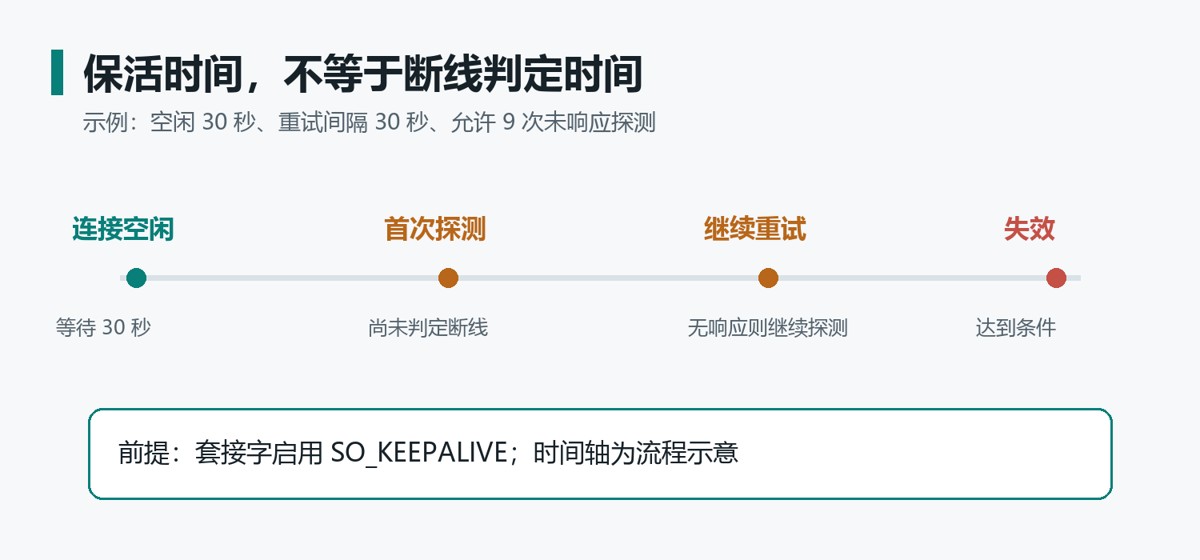
还有个前提常被忽略:程序得主动打开保活开关(SO_KEEPALIVE)。开关没开,内核参数白调。
应用还能给单条连接单独设参数,把内核默认值盖掉。查了半天内核、结果程序压根没开保活——这种事很常见。
同一堆里还有三个「放弃得早一点」:
tcp_syn_retries6 → 5:握手阶段早点放弃,方向对。tcp_retries215 → 12:已经连上的连接早点判死,少占资源。tcp_retries13 → 5:这个反了,是从「早点报错」改成「晚点报错」。
一句话:这三项调的都是「多久放弃」,不是「多快恢复」。放弃得早,故障暴露得快,慢请求也更容易被误杀。
缓冲:两个数看着像,管的不是一回事
net.core.rmem_max = 21299200
net.ipv4.tcp_rmem = 8192 250000 16777216
tcp_rmem 后面那三格数字,是 TCP 自己调节收发缓冲的范围:最小、起步、最大。
rmem_max 不是「TCP 的缓冲上限」。它是应用主动要求「给我这么大的缓冲」时,内核允许的天花板。
所以文档里 rmem_max 给 20MB、tcp_rmem 最大 16MB,两个数不搭,对 TCP 吞吐也没有额外帮助。
中间那个 250000 也看不出出处。它是连接的起步缓冲,写一个不规整的数,不如先看看现在是多少。
真要让大带宽跑满,动的是 tcp_rmem 的上限,而且得先确认拥塞控制和线路的实际带宽时延积(BDP)。
文件数:三个上限,一层管一层
fs.file-max 是全系统总共能开多少文件;fs.nr_open 是单个进程最多能开到多少;limits.conf 里的 nofile 才是进程 真正拿到的那份配额。
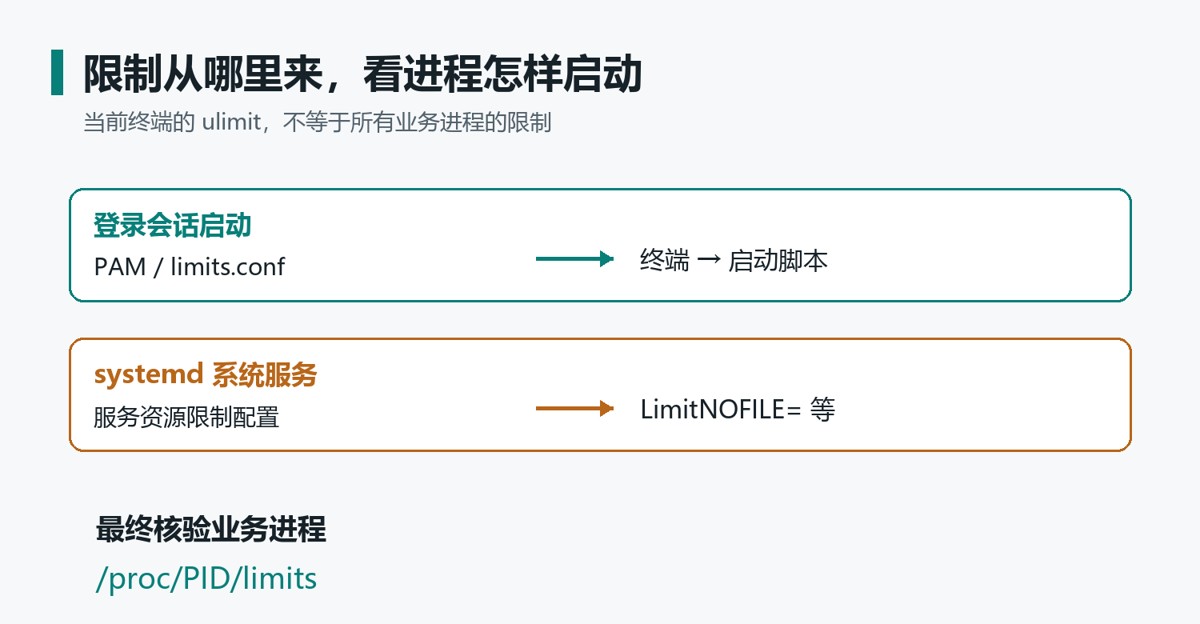
文档把 nofile 和 nr_open 都写成 100 万,刚好顶在边界上:以后想把 nofile 再往上提,得先抬 nr_open。
这里有个反直觉的点:fs.nr_open 的内核默认是 1048576,比文档的 1000000 还大。
照抄这一行,等于把自家更宽的门,换成了更窄的门框,窄了 4.7%。
fs.file-max 也由内核按内存大小自动计算,量级随机器变。先 sysctl -n fs.file-max 看一眼,再决定要不要写死。
剩下几行,一句话带过
- 关 IPv6:方向没错,但先确认没人依赖它,注册中心和监控最容易踩。
all改完,已经在用的网卡不会自动变,只有新网卡才跟着default走。 fs.aio-max-nr:只有程序报io_setup失败(EAGAIN)时才需要动。kernel.sem:数据库类组件确实要用,但文档这组值在不少系统上比默认还小。先sysctl kernel.sem看现状,别把「配置」做成「降配」。
三、这 5 行,别照抄
前两堆最坏就是白费功夫。这一堆不一样:抄进去,会留下隐患。
1.tcp_max_tw_buckets = 10000
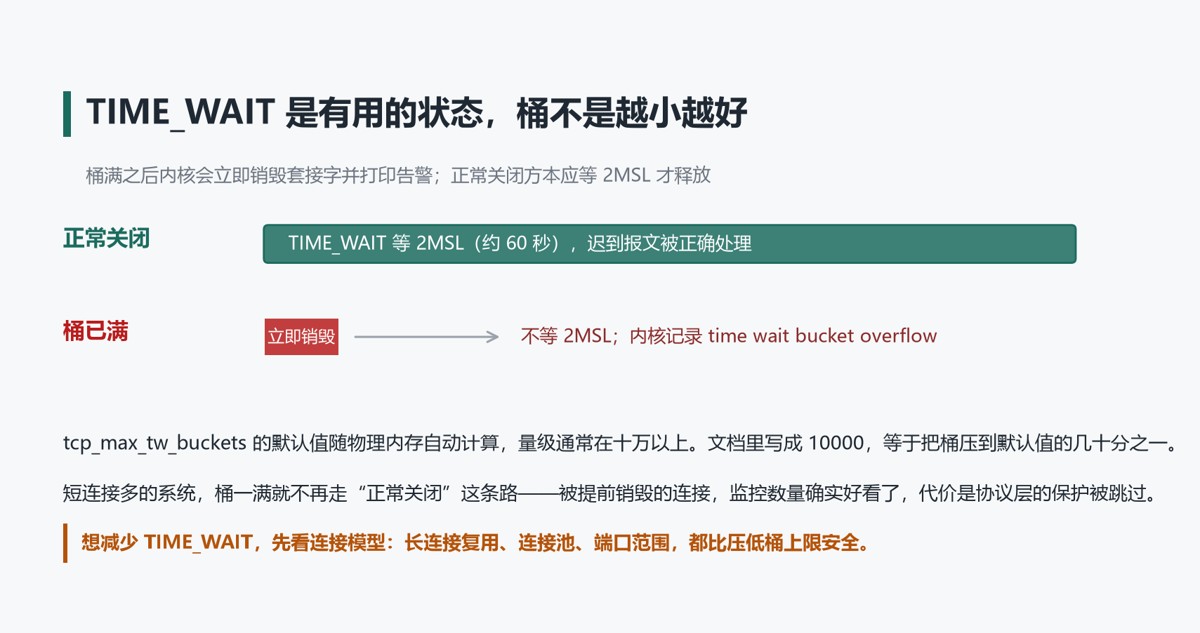
先把 TIME_WAIT 说清楚:它不是「没关干净的连接」,而是正常关门的最后一步。
主动断开的一方会在门口站一会儿,大约 60 秒。站这一会儿,是等网络上迟到的旧包散干净,免得下一个用同一组地址和端口的连接,收到上个住户的信。
tcp_max_tw_buckets 就是「门口允许同时站多少人」。
默认值按内存大小自动算,一般十万往上。压到 1 万,等于门口站满之后,后来的人直接被赶走——内核当场销毁这些套接字,还打一条告警。
监控里的 TIME_WAIT 数字确实好看了。代价是这层保护没了。
内核文档写得很直白:这个上限只是用来防简单的 DoS 攻击,不要人为调低。
短连接多、TIME_WAIT 堆得高,该改的是连接方式——复用长连接、上连接池、扩大本地端口范围,而不是把门口拆了。
2.tcp_tw_reuse = 1
这项在新一点的内核里分了两档:写 1 只对本机回环地址生效,写 2 才对所有出站连接生效。
文档写的是 1。也就是说,改是改了,只改在「自己跟自己通信」的那条路上。
更麻烦的是它看起来「已经开了」,后面没人会再查第二眼。
它还有前提:得开着 TCP 时间戳,经过 NAT 的环境要小心。
3.vm.min_free_kbytes = 767350
这行的注释是「为物理内存的 5%,请根据实际情况进行修改」。
767350 KB 约 749 MB。按 5% 倒推,这台机器大约 15 GB 内存。
换到一台 128 GB 的机器上,照注释算 5%,就是 6.5 GB 的保留内存。
min_free_kbytes 是留给系统的应急余量。余量太少,一紧张就卡死;余量太多,平时能用的内存变少,突发分配更容易触发紧急回收,极端情况下反而更容易 OOM。
内核本来就会按内存大小自动算这个值。手填一个死数字,再配一句「按 5% 改」——数字是死的,注释是活的,抄的人只抄数字。这是最容易被误用的组合。
4.kernel.msgmax = 655360000/kernel.msgmnb = 1048576
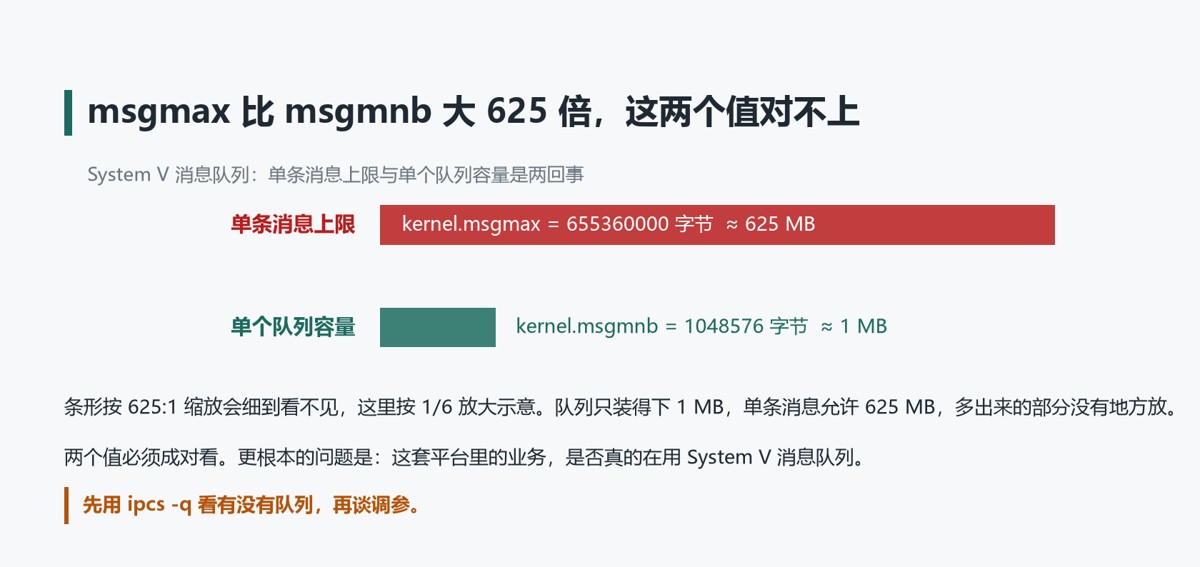
msgmax 管一条消息最大多大,msgmnb 管一个队列总共能装多少。前者约 625 MB,后者约 1 MB。
信封允许装 625 页纸,可邮箱只有 1 页的空间,多出来的部分根本没地方放。这两个值必须成对看,单把 msgmax 放大,等于白改。
更要紧的是先问一句:这套平台的业务,到底用不用 System V 消息队列?ipcs -q 一条命令就能看出来。没有队列,这两个数调多大都是摆设。
5. limits.conf 里的三组unlimited
* soft nproc unlimited
* hard nproc unlimited
* soft memlock unlimited
* hard memlock unlimited
* soft core unlimited
* hard core unlimited
这三组,等于把保险丝换成铜丝。
nproc unlimited:部分发行版上,登录会话会拿不到可用的进程数,表现就是 SSH 登不上。留个明确上限(比如 65535)比unlimited稳。memlock unlimited:任何普通用户都能把任意多内存锁死在物理内存里。这是给了权限,不是做了优化。core unlimited:程序一崩,core 文件能长到和它占的内存一样大。一次崩溃就能把磁盘写满。
还有两个结构性问题:* 号对所有人生效,包括 root;而 systemd 管的服务根本不读 limits.conf,它的限制写在服务自己的 LimitNOFILE= 里。改完 limits.conf 重启服务,可能一点变化都没有。
顺手一个格式坑
文档里有这么一行:
vm.min_free_kbytes = 767350 # 为物理内存的5%,请根据实际情况进行修改
sysctl.conf 只认整行的注释:行首是 # 或 ; 才算。写在值后面的 #,会被当成值的一部分。结果就是 sysctl -p 直接报错,或者写不进去。
把注释挪到上一行就行。坑不大,但它会让「配置生效」在第一步就失败,报错信息还不太说人话。
四、这份文档为什么会长这样
它不是拍脑袋写的。数字里有痕迹:767350 像是从一台 15 GB 的机器上取的;msgmax 看着像某个数据库的推荐值;somaxconn 65535 是上一代「高并发模板」的标配。
它是一份在特定机器、特定组件组合上调出来的样本值,被写成了通用清单。
样本离开那台机器,就变成三种错:白抄、错配、反着改。
还有一种更隐蔽的:清单里叫「优化」的那几步,其实是把你机器上更宽松的默认值改小。不先对一遍当前值,根本看不出来。
所以判断一份清单能不能直接用,第一件事不是看它写得多全,而是拿当前值比一比。
五、真要改,按这个顺序
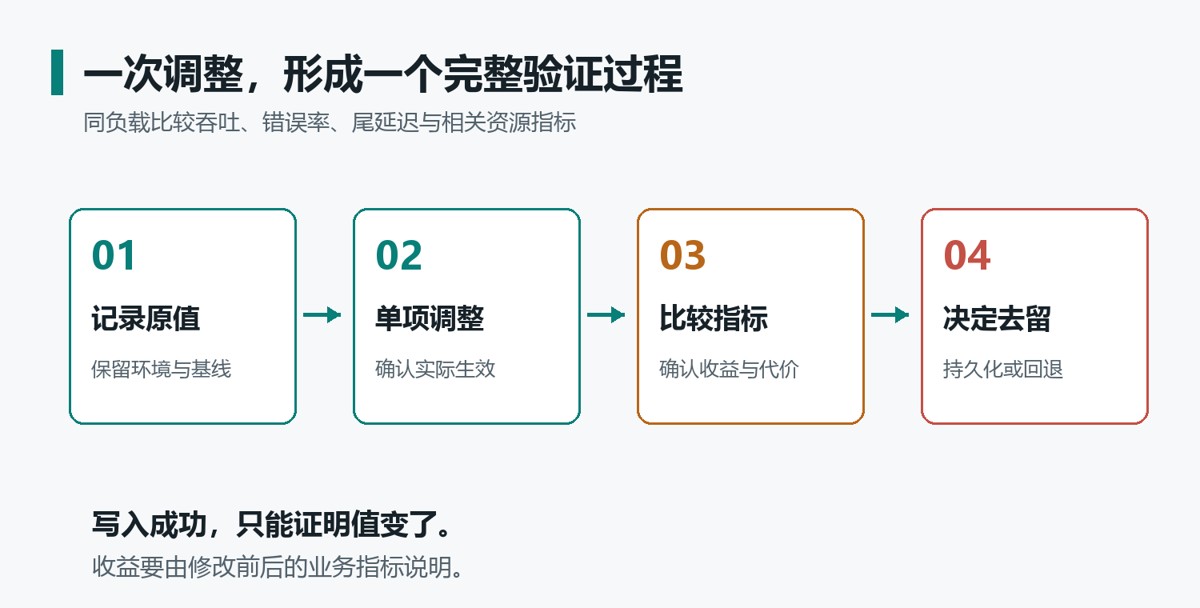
先看自己现在是什么样,别拿别人的默认值当自己的现状:
cat /etc/os-release
uname -r
sysctl -n net.core.somaxconn fs.nr_open fs.file-max vm.min_free_kbytes
再看业务进程实际拿到多少,这一步比看配置文件靠谱:
APP_PID=12345
cat "/proc/$APP_PID/limits"
改的时候一次只动一项,同样的负载对比。有效果再落盘,写进单独文件,别继续往 /etc/sysctl.conf 里堆:
sudo sysctl -w net.core.somaxconn=8192          # 临时验证
sudo sysctl -p /etc/sysctl.d/90-app-tuning.conf # 持久化加载
注意:sysctl -p 不带路径时只读 /etc/sysctl.conf,不会顺手加载 sysctl.d 里的文件。写进 sysctl.d 的,重启后由 systemd-sysctl 统一加载。
回退也要成对:删掉配置行只改了「下次开机」,正在跑的值还在。
最后
回到开头那个问题:照清单配完,为什么高峰还是超时?
因为清单回答的是「别人机器上配了什么」,不是「你的服务卡在哪」。
34 行内核参数,11 行可以删,18 行要照着自己的机器重算,5 行最好别碰。另外 10 行 limits.conf,先把 unlimited 和 * 号收一收。
最省事的办法,反而是最费事的那一步:趁故障发生时,抓一份队列、连接和进程的数据。数据在手,哪一行该改,自己就有答案。
以上就是Linux服务器内核参数优化实践教学:哪些该改,哪些别照抄的详细内容,更多关于Linux参数优化的资料请关注脚本之家其它相关文章!
相关文章

Linux下安装Oracle(CentOS-Oracle 12c)的方法
这篇文章主要介绍了Linux下安装Oracle(CentOS-Oracle 12c)的方法,本文实例讲解,介绍的非常详细,具有参考借鉴价值,感兴趣的朋友一起看看吧2016-11-11 本文给大家详细讲述了在LINUX中Centos7搭建vsftpd服务的详细操作方法,需要的朋友参考下。2018-02-02
 大家好,本篇文章主要讲的是Linux网络设置之基础操作命令详解,感兴趣的同学快来看一看吧,对你有用的话记得收藏起来,方便下次浏览2021-11-11

Ubuntu 16.04源码编译安装Apache 2.4.25教程
这篇文章主要为大家详细介绍了Ubuntu 16.04源码编译安装Apache 2.4.25,具有一定的参考价值,感兴趣的小伙伴们可以参考一下2017-01-01 这篇文章主要介绍了修改CentOS服务器时间为北京时间的相关知识,非常不错,具有一定的参考借鉴价值 ,需要的朋友可以参考下2018-10-10
 鉴于 CentOS 7 已结束官方支持(EOL),但许多生产环境仍在使用 CentOS 7 或更旧版本,为此,需切换至国内镜像源以确保正常使用,本文将详细介绍如何将阿里云仓库配置为YUM源,需要的朋友可以参考下2025-10-10
 sudo命令允许受信任的用户作为另一个用户运行程序,默认情况下是root用户。这篇文章主要介绍了Linux 中不输入密码运行 sudo 命令的方法,需要的朋友可以参考下2019-07-07
 这篇文章主要介绍了ubuntu16.04 升级内核的方法步骤,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友们下面随着小编来一起学习学习吧2020-08-08
 本篇文章主要介绍了linux下如何创建守护进程的步骤,小编觉得挺不错的,现在分享给大家,也给大家做个参考。一起跟随小编过来看看吧2017-07-07
 本文介绍了Linux如何通过常用命令查看CPU、内存、磁盘、系统版本、内核、网卡IP和主板型号等信息,并提供了一个一键查询脚本,助你轻松获取服务器所有硬件详情2026-10-10
最新评论