

PostgreSQL加索引后查询反而更慢的常见场景与解决方法
本文摘要:生产库中给过滤列加索引后,相同查询的执行时间不降反升。成本驱动优化器因候选路径变化重新估算成本,可能选择实际更差的计划。该现象取决于数据分布、存储 I/O 特性和成本参数,不同环境表现差异较大。
一、问题与结论
给慢查询的过滤列加上索引后,EXPLAIN (ANALYZE, BUFFERS) 显示索引确实被 planner 采用,但 Buffers 中 shared read 次数显著增加,实际耗时高于加索引前。这不是 bug——新索引改变了 planner 的候选方案空间,估算成本最低的路径在实际执行中可能最慢。
PostgreSQL 的成本驱动优化器(cost-based planner)在每条查询规划时枚举所有可用访问路径——顺序扫描、各索引扫描——逐一估算成本后选择最低方案。以下三种情形最容易触发加索引后回退:
- 低选择性列索引:索引列只有少量不同值(如
status仅 3 个值),索引过滤效果有限,bitmap 堆页访问的随机 I/O 累积开销超过顺序扫描。 - JOIN 策略切换:新索引让 planner 将 hash join 改为 nested loop + index scan,外层行数较大时,上万次索引查找的随机 I/O 被低估。
- ANALYZE 刷新统计信息:加索引触发的统计收集"纠正"了旧索引的过度乐观估算,planner 放弃了原本高效工作的旧路径。
二、排查与选择依据
对比加索引前后的执行计划是定位问题的第一步。
排查步骤:
- 加索引前用
EXPLAIN (ANALYZE, BUFFERS)记录基线计划,关注Join Type、Node Type、Actual Total Time。 - 加索引并执行
ANALYZE后再次运行相同的EXPLAIN,逐项对比。 - 检查新索引是否被实际使用:
SELECT indexrelname, idx_scan
FROM pg_stat_user_indexes
WHERE relname = 'orders';
如果 idx_scan = 0,说明 planner 从未选用它。如果 idx_scan > 0 但查询变慢,则属于情形 1 或 2。
- 在会话级别用
enable_*参数强制切换路径,确认哪种方式实际更快:
SET enable_hashjoin = off;   -- 强制 nested loop
EXPLAIN (ANALYZE, BUFFERS) SELECT ...;

RESET enable_hashjoin;
SET enable_nestloop = off;   -- 强制 hash join
EXPLAIN (ANALYZE, BUFFERS) SELECT ...;

RESET enable_nestloop;
替代方案与取舍
| 方案 | 选择条件 | 代价 | 边界 |
|---|---|---|---|
| 删除低选择性单列索引 | 列不同值 < 5,且该列是唯一过滤条件 | 该列上其他查询可能受益于它 | 其他查询若依赖此索引,删除会引发新的慢查询 |
改为复合索引 (col1, col2) | 查询同时过滤两列 | 索引体积增大,写入维护成本上升 | 仅覆盖列顺序一致的查询模式 |
调低 random_page_cost 至 1.1 | 已确认存储为 SSD 且此参数从未调整过 | 全局影响 planner 决策,可能过度选择 index scan | HDD 环境不适用;默认 4.0 是 HDD 基准 |
使用部分索引(带 WHERE) | 查询条件固定且可精确描述 | 需维护 WHERE 与查询条件的一致性 | 条件变化后需重建索引 |
如果你的回退原因是情形 2(JOIN 策略切换),删除或重建索引都不是正解——应先确认 work_mem 是否足够让 hash 表驻留内存,或在特定查询上通过 enable_nestloop 限制 planner 选择。如果是情形 3(统计信息刷新导致旧索引被弃用),新计划往往才是更准确的选择。
三、关键原理
random_page_cost 与 seq_page_cost 的比值决定索引扫描偏好。默认 seq_page_cost = 4.0,random_page_cost = 4.0——这个比值隐含假设"随机读一页与顺序读一页成本相同",是 HDD 时代基准。PostgreSQL 9.6 起建议 SSD 环境调至 random_page_cost = 1.1。若环境已迁移至 SSD 但参数未调,planner 会高估随机 I/O 代价,倾向放弃索引。
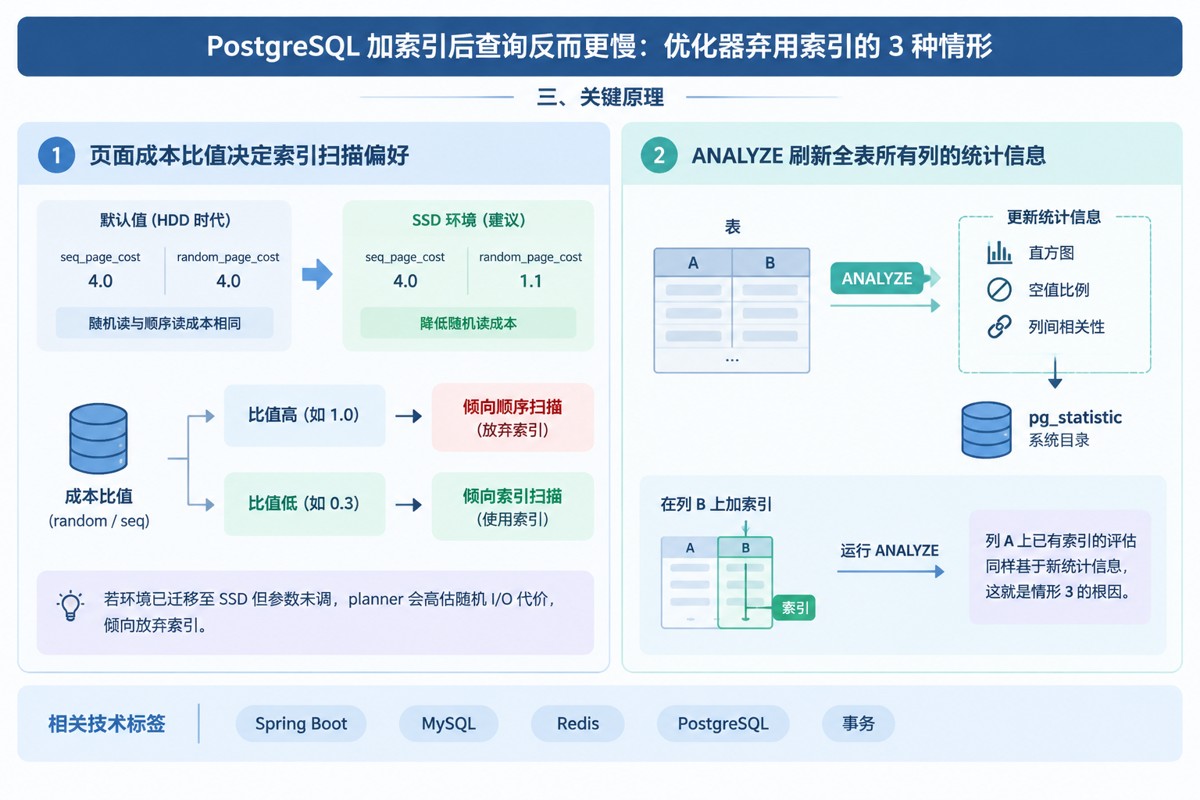
ANALYZE 刷新的是全表所有列的统计信息,不是只有新索引列。直方图、空值比例、列间相关性全部更新,写入 pg_statistic 系统目录。在列 B 上加索引后运行 ANALYZE,列 A 上已有索引的评估同样基于新统计信息——这就是情形 3 的根因。
四、可运行示例
环境:PostgreSQL 16(Docker 容器),本地单机。
docker run -d --name pg16 -p 5432:5432 \
  -e POSTGRES_PASSWORD=test postgres:16
以下 SQL 复现情形 2(JOIN 策略从 hash 切换为 nested loop):
CREATE TABLE customers (
    id SERIAL PRIMARY KEY,
    region VARCHAR(50)
);
CREATE TABLE orders (
    id SERIAL PRIMARY KEY,
    customer_id INTEGER NOT NULL,
    amount DECIMAL(10,2)
);

INSERT INTO customers (region)
SELECT CASE
    WHEN random() < 0.33 THEN 'north'
    WHEN random() < 0.66 THEN 'south'
    ELSE 'east' END
FROM generate_series(1, 10000);

INSERT INTO orders (customer_id, amount)
SELECT ceil(random() * 10000)::INTEGER,
       round((random() * 1000)::numeric, 2)
FROM generate_series(1, 1000000);

ANALYZE customers;
ANALYZE orders;
加索引前执行:
EXPLAIN (ANALYZE, BUFFERS)
SELECT c.region, sum(o.amount)
FROM customers c
JOIN orders o ON c.id = o.customer_id
GROUP BY c.region;
预期输出(加索引前,planner 选择 hash join):
HashAggregate
  Hash Join
    Seq Scan on orders o
    Hash
      Seq Scan on customers c
加入索引并刷新统计后再次执行:
CREATE INDEX idx_orders_customer ON orders(customer_id);
ANALYZE orders;

EXPLAIN (ANALYZE, BUFFERS)
SELECT c.region, sum(o.amount)
FROM customers c
JOIN orders o ON c.id = o.customer_id
GROUP BY c.region;
预期输出(加索引后,planner 切换到 nested loop):
Nested Loop
  Seq Scan on customers c
  Index Scan using idx_orders_customer on orders o
    Actual Loops: 10000
Actual Loops: 10000 表明 orders 被随机查找了 1 万次(等于 customers 的行数)。
以上输出为根据官方文档中 planner 行为描述推导出的预期结果,标注为未验证——实际数值因硬件、work_mem 和 random_page_cost 配置而异。如果两次执行的 Join Type 相同,可用前述 enable_* 参数强制对比。
常见失败及修复:如果你的 PostgreSQL 配置了较大的 work_mem(如 256 MB),hash join 的哈希表可以完整驻留内存,此时 planner 可能在加索引后仍然选择 hash join,无法复现回退。修复方法是在会话级别临时降低 work_mem 以缩小 hash 表可容纳的数据量,或改用更大的数据集。
五、验证结果与边界
统计信息过时导致的假性回退:如果加索引前表经历了大量写入但未及时 ANALYZE,planner 使用的旧统计信息可能高估了旧索引的选择性。加索引后触发 ANALYZE,新统计信息"纠正"了这个偏差,planner 放弃了旧索引——这不是回退,而是修正。应在加索引前先执行 ANALYZE 确保统计信息新鲜。
索引的三方面代价:
- 写入放大:每条
INSERT/UPDATE/DELETE都需维护 B-tree。写密集型表(日志、事件流)应严格控制索引数量。 - 缓存挤压:索引占用
shared_buffers空间,过多索引可能将热点数据页挤出缓存。 - planner 决策复杂度:候选路径越多,统计信息不准时选错计划的概率越大。
什么时候不该用本文思路:如果你的问题是"索引存在但 planner 从未选择它"(idx_scan = 0),应排查查询是否匹配索引的列顺序、索引列是否被函数包裹(如 LOWER(col) 与 col 不匹配),这属于索引设计问题,与本文讨论的"加索引后性能回退"不同。
思考
- 在线 DDL 工具重建索引后统计信息是否会自动重新收集,是否需要手动
ANALYZE? - 同一表上存在多个低选择性索引时,planner 搜索空间的膨胀如何量化评估?
以上就是PostgreSQL加索引后查询反而更慢的常见场景与解决方法的详细内容,更多关于PostgreSQL加索引后查询反而更慢的资料请关注脚本之家其它相关文章!
相关文章
 PostgreSQL的触发器Trigger是一类特殊的数据库对象,本文主要介绍了PostgreSQL创建触发器的实现示例,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友们下面随着小编来一起学习学习吧2025-06-06
 这篇文章主要介绍了PostgreSQL批量update与oracle差异,本文给大家介绍的非常详细,对大家的学习或工作具有一定的参考借鉴价值,需要的朋友可以参考下2021-01-01
 在现代软件开发和运维实践中,数据库作为核心基础设施,其稳定性和性能至关重要,PostgreSQL 作为一款功能强大、开源且高度可靠的数据库管理系统,持续推出新版本以增强性能、安全性和功能特性,所以本文将深入探讨 PostgreSQL 数据库升级的完整流程,需要的朋友可以参考下2026-03-03
 这篇文章主要介绍了对Postgresql中的json和array使用介绍,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧2021-01-01

详解PostgreSQL 14.4安装使用及一些安装的异常问题
这篇文章主要介绍了PostgreSQL 14.4的安装以及使用以及一些安装的异常,本文通过图文并茂的形式给大家介绍的非常详细,对大家的学习或工作具有一定的参考借鉴价值,需要的朋友可以参考下2022-07-07 基于PostgreSQL实现的俄罗斯方块游戏项目Tetris-SQL,通过纯SQL代码和数据库操作重构了经典游戏逻辑,展现了SQL语言的图灵完备性和技术潜力,本文介绍PostgreSQL使用SQL实现俄罗斯方块的示例,感兴趣的朋友一起看看吧2022-04-04
 这篇文章主要介绍了Postgresql 截取字符串的案例,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧2021-02-02

Postgresql的pl/pgql使用操作--将多条执行语句作为一个事务
这篇文章主要介绍了Postgresql的pl/pgql使用操作--将多条执行语句作为一个事务,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧2021-01-01 这篇文章主要介绍了PostgreSQL 慢查询SQL跟踪操作,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧2021-01-01
 这篇文章主要介绍了postgresql关于like%xxx%的优化操作,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧2021-01-01
最新评论