

MySQL加索引后性能下降的原因与解决方法
本文摘要:接口加索引后从 80ms 涨到 1.4s,并发稍高就拖垮 Pod。用 EXPLAIN ANALYZE 定位 3 万次回表根因,以覆盖索引消除回表。
一、问题与结论
复现环境:JDK 17、Spring Boot 3.2.5、MySQL 8.0.36、mysql-connector-j 8.4.0、HikariCP 默认 10 连接。表 orders 约 200 万行,其中 user_id = 42 AND status = 1 恰好命中 3 万行。
结论先给:变慢不是索引失效,而是 idx_user_status 命中 3 万行后逐行回表取 remark 列。3 万次聚簇索引查找把单查询推到秒级,50 并发把连接池打满,最后连健康检查一起失败。
故障时序与日志:
T+0.1s  MySQL 走 idx_user_status 命中 30000 行,逐行回表取 remark
T+1.5s  返回 30000 行 ≈ 6MB JSON,Jackson 序列化,CPU 短暂飙高
2025-03-11 14:02:18.341  INFO  c.e.o.OrderController : 查询耗时: 1427ms, 返回 30000 条
2025-03-11 14:02:48.402 ERROR c.z.h.p.HikariPool : HikariPool-1 - Connection is not available, request timed out after 30000ms.
2025-03-11 14:03:05.119  WARN  c.e.o.OrderController : /actuator/health -> 503 (liveness probe 失败,Pod 重启)
放大关系是一道除法:50 并发 ÷ 10 连接 = 5 轮排队,末位等待 5 × 1.4s ≈ 7s;持续流量让队列继续增长,一旦等待超过 connection-timeout 30s 就抛上面那行异常。连接池耗尽后 /actuator/health 同样拿不到连接,K8s 判定不健康并重启 Pod。日志中的耗时数字来自故障记录,未在本机基准复测。
二、排查与选择依据
先看执行计划的真实行数,再决定改哪里。传统 EXPLAIN 只给估算值,EXPLAIN ANALYZE(8.0.18+)会输出实际行数与实际耗时。
EXPLAIN ANALYZE
SELECT id, user_id, status, amount, remark
FROM orders
WHERE user_id = 42 AND status = 1;
判读要点(结构为真实输出格式,数字为示意):
-> Filter: ((orders.user_id = 42) and (orders.status = 1))  (actual time=0.04..1287 rows=30000 loops=1)
   -> Index range scan using idx_user_status on orders      (actual time=0.03..601 rows=30156 loops=1)
rows=30000 且 Extra 里没有 Using index,就是回表 3 万次;把 remark 从 SELECT 中去掉后 Extra 变为 Using index,耗时掉一个量级。接着用 SHOW STATUS LIKE 'Innodb_buffer_pool_read%'; 查 Innodb_buffer_pool_reads,它不为 0 就说明部分回表落到了磁盘随机 I/O,这是 200ms 与 1.4s 的分水岭。
替代方案与取舍
| 方案 | 选择条件 | 代价 | 边界(什么时候不用) |
|---|---|---|---|
| 覆盖索引(本文方案) | 返回列可控、查询稳定 | 索引变大、写入变慢 | 写多读少、返回列经常变化时不用 |
LIMIT 或游标分页 | 产品允许只看前 N 条 | 改接口契约,前端要适配 | 必须全量导出时不用 |
分批回表(先取主键列表再 IN 查) | 行数大且确实要全量 | 多一次网络往返,代码复杂度上升 | 命中行数 < 1000 时收益不明显 |
| Redis 缓存结果 | 查询热点稳定、可容忍短暂不一致 | 3 万行 JSON ≈ 6MB 大 key,失效策略要单独设计 | 写入频繁或要求强一致时不用 |
不该用本文方案的场景:remark 属于高频变更字段、或表以写入为主时,加宽索引等于把代价转嫁给所有 INSERT/UPDATE,此时优先分页或分批回表。
三、关键原理
三个事实决定上面的判断:
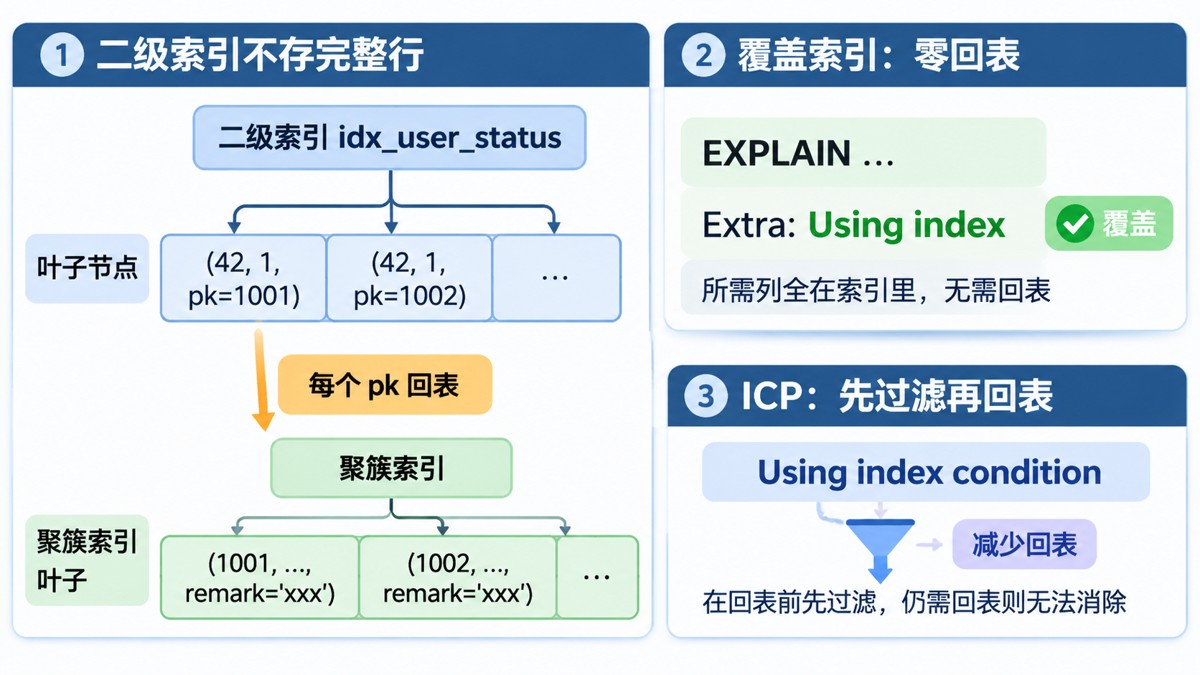
- 二级索引叶子节点只存「索引列值 + 主键值」,不存完整行。查询要的列不在索引里,就必须拿主键回聚簇索引重新定位,每行一次,3 万行就是 3 万次 B+ 树查找。
EXPLAIN的Extra: Using index表示覆盖索引,所需列全在索引里,零回表。- ICP(
Using index condition)把部分WHERE条件下推到存储引擎层,在回表前先过滤,能减少回表次数,但只要还缺列就消不掉回表。
二级索引 idx_user_status 叶子:  (42, 1, pk=1001), (42, 1, pk=1002), ...
                                       ↓ 每个 pk 回聚簇索引取 remark
聚簇索引叶子:                     (1001, ..., remark='xxx'), ...
四、可运行示例
环境:本地 MySQL 8.0.36 实例,JDK 17 + Spring Boot 3.2.5。输入:GET /api/orders?userId=42&status=1。
步骤 1:建表。
CREATE DATABASE demo; USE demo;
CREATE TABLE orders (
    id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    user_id BIGINT UNSIGNED NOT NULL,
    status TINYINT UNSIGNED NOT NULL DEFAULT 0,
    amount DECIMAL(12,2) NOT NULL DEFAULT 0,
    created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
    remark VARCHAR(255) DEFAULT NULL,
    INDEX idx_user_status (user_id, status)
) ENGINE=InnoDB;
步骤 2:灌数据。用数字序列表或存储过程循环插入,保证总行数 ≥ 200 万且 user_id = 42, status = 1 恰好 3 万行,最后执行 ANALYZE TABLE orders;。
步骤 3:跑上一节的 EXPLAIN ANALYZE,再把 SELECT 中的 remark 去掉做对比。
步骤 4:Spring Boot 侧请求接口并计时。
@GetMapping
public List<OrderVO> list(@RequestParam Long userId, @RequestParam Integer status) {
    long start = System.currentTimeMillis();
    List<OrderVO> result = orderMapper.selectByUserAndStatus(userId, status);
    log.info("查询耗时: {}ms, 返回 {} 条", System.currentTimeMillis() - start, result.size());
    return result;
}
预期输出:带 remark 的查询无 Using index、秒级耗时;去掉 remark 后 Extra: Using index、几十毫秒。
实际输出:需在目标机器复测。本文未执行基准测试,秒级与毫秒级均为量级推算,未验证。
常见失败:背景数据灌不满。information_schema.columns 自连接的实际行数取决于实例里的表数量,常远小于预期,回表代价被低估会让整个结论不成立;改用数字序列表即可。
五、验证结果与边界
验证顺序:EXPLAIN ANALYZE 看 rows 与 Extra → Innodb_buffer_pool_reads 判断是否落盘 → 并发压测确认 Connection is not available 消失。三条都对上才算复现。
可迁移到其他项目的四条结论:
- 回表次数 ≈ 索引命中行数,先看
Extra有没有Using index,再谈索引写法。 - 并发放大用「单查询秒数 × 并发 ÷ 连接数」估算,与框架无关。
- 回表在 buffer pool 命中时是内存操作,命中几千行以内基本无感,别为小结果集加宽索引。
- MySQL 8.0.3 起二级索引按主键排序,回表访问更局部化、随机 I/O 更少,但回表次数本身不变。
适用边界:只适合返回列可控、读多写少的查询。分库分表不解决单表回表,调整锁粒度也与本问题无关,不要混为一谈。
思考
- 覆盖索引把写入代价转嫁给所有
INSERT/UPDATE,你的系统更怕读慢还是写慢? - 返回列越来越多时,分页、分批回表和加宽索引,哪个的维护成本更低?
到此这篇关于MySQL加索引后性能下降的原因与解决方法的文章就介绍到这了,更多相关MySQL加索引后性能下降内容请搜索脚本之家以前的文章或继续浏览下面的相关文章希望大家以后多多支持脚本之家!
相关文章
 常用的mysql截取函数有:left(), right(), substring(), substring_index(),很多新手朋友不是很了解,接下来详细说明,需要的朋友可以参考下2012-12-12
 一个优秀的kill MySQL连接的一个工具,是percona toolkit的一部分,在因为空闲连接较多导致超过最大连接数、某个有问题的sql导致mysql负载很高时,都需要将一些连接kill掉,这个工具主要就是这个用途2016-04-04
 这篇文章主要介绍了MySQL数据库升级需要注意的地方,帮助大家更好的理解和学习,感兴趣的朋友可以了解下2020-08-08
 本文主要介绍解决MySQL句柄占用过多的方法,简单实用,需要的朋友可以参考下。2016-05-05
 文章讨论了数据库异步同步的优化思路,包括三个主要方面:幂等性、时序和延迟,作者还分享了MySQL配置文件的优化经验,并鼓励读者提供支持2025-01-01
 在本篇文章里小编给大家整理的关于数据库查询哪个对像里面包含什么字段方法语句有需要的朋友们可以学习下。2019-08-08
 本文通过实例向大家介绍了MYSQL子查询和嵌套查询优化的相关内容,附代码示例,具有一定参考价值。希望对大家使用MySQL有所帮助。2017-10-10
 这篇文章主要介绍了mysql如何将id重新修改为递增,本文模拟场景结合实例代码给大家介绍的非常详细,对大家的学习或工作具有一定的参考借鉴价值,需要的朋友可以参考下2023-08-08
 公司网站访问量越来越大,MySQL自然成为瓶颈,因此最近我一直在研究 MySQL 的优化,第一步自然想到的是 MySQL 系统参数的优化,作为一个访问量很大的网站(日20万人次以上)的数据库系统,不可能指望 MySQL 默认的系统参数能够让 MySQL运行得非常顺畅。2011-03-03
 在MySQL中,EXPLAIN命令是一种非常重要的查询优化工具,它可以帮助我们分析SQL查询语句的执行计划,以及如何优化它们。本文介绍了Explain命令在优化查询中的实际应用,感兴趣的小伙伴可以参考阅读2023-04-04
最新评论