OpenClaw错误处理实战:优雅降级、重试机制与熔断器设计
 我要评论
摘要:AI Agent 上线后,模型 429 限流、工具超时、网络抖动、业务规则冲突几乎是常态。一旦缺乏系统化的错误处理机制,Agent 就会从“智能助手”退化成“随机报错器”。本文面向正在落地 OpenClaw 的开发者与运维人员,系统讲解错误分类方法、指数退避与抖动、模型/工具/功能三层优雅降级、熔断器 CLOSED/OPEN/HALF_OPEN 状态机、结构化日志与分级告警联动,并给出可直接落地的 YAML 配置与 Python 代码模板。掌握这些机制,你的 Agent 才能从“本地能用”真正走向“线上稳用”。
一、引言:为什么错误处理是 Agent 的生命线
你有没有遇到过这样的情况:一个 Agent 工作流在本地测试时行云流水,一旦上线就频繁掉链子?模型 API 返回 429,搜索工具超时,飞书通知发不出去,用户看着“正在思考……”转了半天却没有任何反馈。
这不是个案。AI Agent 的调用链比传统应用长得多——大模型服务、第三方 API、向量数据库、消息中间件、网络链路,任意一环抖动都会放大成整个链路的失败。没有错误处理的 Agent,就像一个没有免疫系统的人,风吹草动就可能倒下。
错误处理不是“锦上添花”,而是生产级 Agent 的生命线。它决定了你的 Agent 是实验室玩具,还是能在真实业务中 7×24 小时运行的工具。OpenClaw 把错误处理放在架构设计的核心位置:从 Agent 执行器到 Skill 模板,从模型调用到工具执行,处处都有重试、降级、熔断、告警的插槽。
本文会带你从错误分类开始,逐层攻破重试策略、优雅降级、熔断器、告警通知与用户提示,最后给出一套可以直接落地的配置方案。
二、概念拆解:错误处理、重试机制与优雅降级
标题里提到的三个核心概念,是构建高可用 Agent 的基石。我们先把它们的定义和边界讲清楚。
2.1 错误处理:不只是 try-catch
错误处理(Error Handling)是系统对异常情况的完整响应流程,包括:识别错误类型、决定是否重试、选择降级路径、记录日志、触发告警、向用户给出友好提示。
它不只是代码里的 try-except。一个好的错误处理框架要回答三个问题:发生了什么?谁来恢复?用户看到什么? 只有这三环都闭合,错误才不会悄无声息地吞噬用户体验。
2.2 重试机制:给暂时性错误一次补救机会
重试机制(Retry Mechanism)针对的是暂时性错误——网络抖动、服务端瞬时过载、DNS 解析延迟等。它的核心假设是:现在失败不代表下一秒也会失败。
但重试不能粗暴。固定间隔重试容易造成“重试风暴”,指数退避(Exponential Backoff)配合抖动(Jitter)才是生产环境的标配。后文会给出可直接使用的实现。
2.3 优雅降级:用 Plan B 守住核心体验
优雅降级(Graceful Degradation)指的是当主路径不可用时,主动切换到次级但可接受的方案,而不是直接报错或卡死。对 Agent 来说,常见降级包括:主模型切换到备用模型、实时搜索切换到本地缓存、非核心功能临时关闭。
降级的目标是保证核心可用。它不是追求完美,而是在不完美中保住用户最需要的 80% 体验。
三、AI Agent 错误全景图:四大类错误你都得防
在制定恢复策略之前,必须先给错误分类。不同类型的错误,恢复方式截然不同。
3.1 模型错误
模型错误来自大模型服务本身,典型表现包括:
- 429 Rate Limited:调用频率超过服务商限制。
- 400 context_length_exceeded:上下文长度超过模型窗口。
- 503 Service Unavailable:模型服务端暂时不可用。
- 输出格式异常:返回内容无法按预期 JSON 解析。
- 内容安全过滤:触发安全策略,模型拒绝生成。
这类错误的根因通常不在你的代码,但你可以通过重试、模型降级、上下文裁剪来应对。
3.2 工具错误
工具错误发生在 Agent 调用外部工具时:
- 工具执行超时,尤其是搜索、OCR、数据库查询。
- 参数格式错误,常见于动态构造工具入参。
- 权限不足,访问目标资源被拒绝。
- 返回异常数据,如空值、非预期格式。
工具错误的可控性比模型错误高,通常可以通过参数校验、超时设置、工具降级来缓解。
3.3 网络错误
网络错误具有短暂性和随机性:
- 连接超时、连接重置、SSL 握手失败、DNS 解析失败。
这类错误大多可以通过带抖动的重试恢复,不需要立即走降级路径。
3.4 业务错误
业务错误来自业务逻辑本身:
- 用户意图无法识别、业务规则冲突、数据状态不一致、权限不足。
这类错误重试通常无效,需要的是清晰的用户提示和明确的功能降级。
3.5 四类错误对比
| 错误类型 | 常见原因 | 可重试性 | 典型恢复策略 |
|---|---|---|---|
| 模型错误 | 限流、超长、服务不可用 | 部分可重试 | 指数退避 + 模型降级 |
| 工具错误 | 超时、参数错误、权限不足 | 视情况而定 | 超时可重试 + 工具降级 |
| 网络错误 | 连接超时、DNS 失败、SSL 错误 | 大多可重试 | 指数退避 + 抖动 |
| 业务错误 | 意图不明、规则冲突、权限不足 | 通常不可重试 | 用户提示 + 功能降级 |
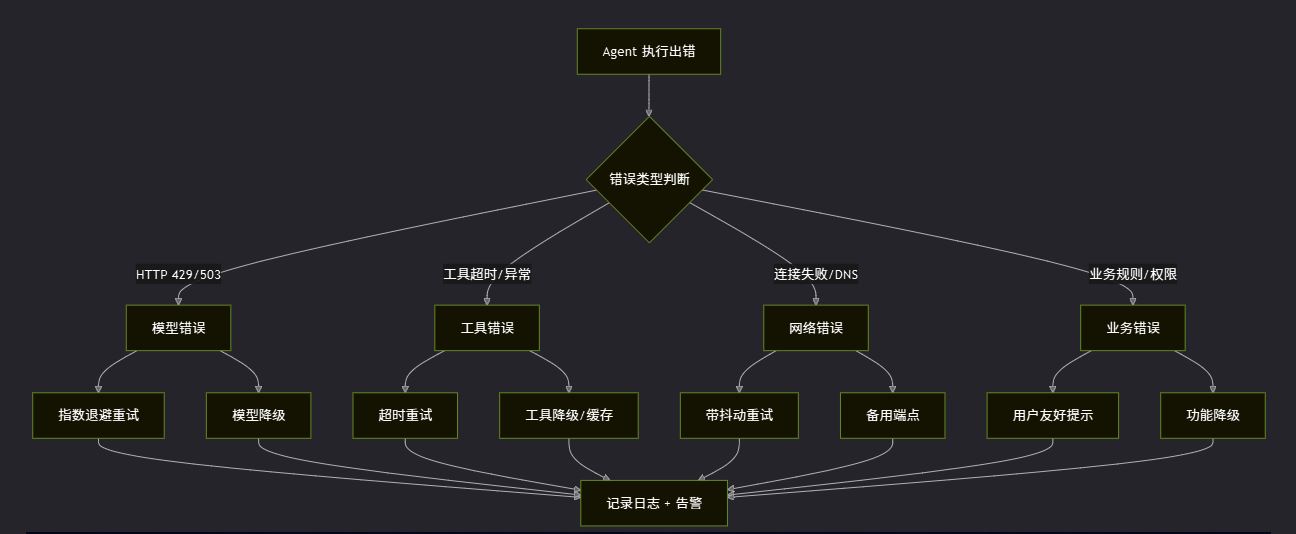
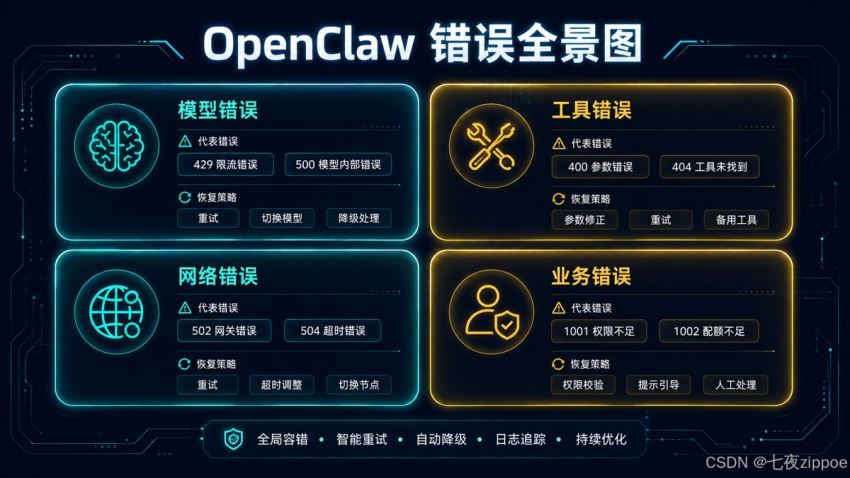
图 1:OpenClaw 四类错误分布与典型恢复策略总览
四、重试策略设计:不是简单地说“再来一次”
很多人对重试的理解就是“失败了再试一次”。但在分布式系统中,粗暴重试会让事情更糟:100 个 Agent 同时重试一个已经过载的 API,无异于一次小型 DDoS。
4.1 指数退避 + 抖动
指数退避的核心思想是:每次重试的等待时间按指数增长,给服务端喘息时间。抖动则是在等待时间上加一个随机偏移,避免多个请求在同一时刻重试。
import asyncio
import random
from typing import Callable, TypeVar, Optional
T = TypeVar("T")
# 通用重试函数:支持指数退避 + 随机抖动
async def retry_with_backoff(
    fn: Callable[..., T],            # 被重试的异步函数
    max_retries: int = 3,            # 最大重试次数
    base_delay: float = 1.0,         # 初始延迟(秒)
    max_delay: float = 60.0,         # 最大延迟上限(秒)
    jitter: float = 0.4,             # 抖动幅度,0.0-1.0
    retryable: tuple = (Exception,), # 可重试的异常类型
) -> Optional[T]:
    """带指数退避与抖动的通用重试函数。"""
    for attempt in range(max_retries + 1):
        try:
            return await fn()
        except retryable as e:
            if attempt == max_retries:
                print(f"[Retry] 达到最大重试次数 {max_retries},放弃执行")
                return None
            raw = min(base_delay * (2 ** attempt), max_delay)
            delta = random.uniform(-jitter, jitter) * raw
            delay = max(0.1, raw + delta)
            print(f"[Retry] 第 {attempt + 1} 次失败: {e},{delay:.1f}s 后重试")
            await asyncio.sleep(delay)
    return None
代码解释(100 字+):retry_with_backoff 接收被重试函数 fn、最大重试次数、初始延迟、最大延迟、抖动系数和可重试异常类型。每次失败后,等待时间按指数增长(1s → 2s → 4s),但不超过 max_delay;同时叠加 ±40% 的随机抖动,把重试请求打散。retryable 参数让你精确控制哪些异常值得重试,避免对 400、401 这类不可重试错误做无用功。
4.2 重试策略对比
| 策略 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 固定间隔重试 | 实现简单 | 容易造成重试风暴 | 低并发脚本 |
| 线性退避 | 逐步增加等待 | 打散效果一般 | 简单业务 |
| 指数退避 | 高效利用等待时间 | 多实例可能同步重试 | 单实例服务 |
| 指数退避 + 抖动 | 既高效又打散 | 实现稍复杂 | 生产环境首选 |
| 自适应退避 | 根据实时指标动态调整 | 需要监控数据支撑 | 大规模分布式系统 |
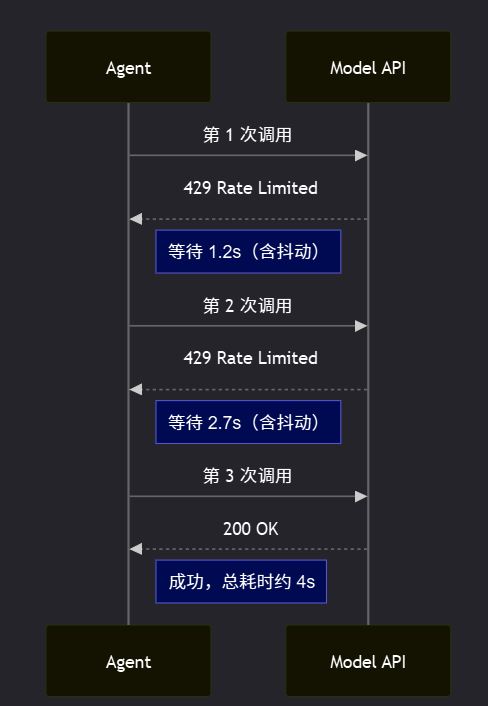
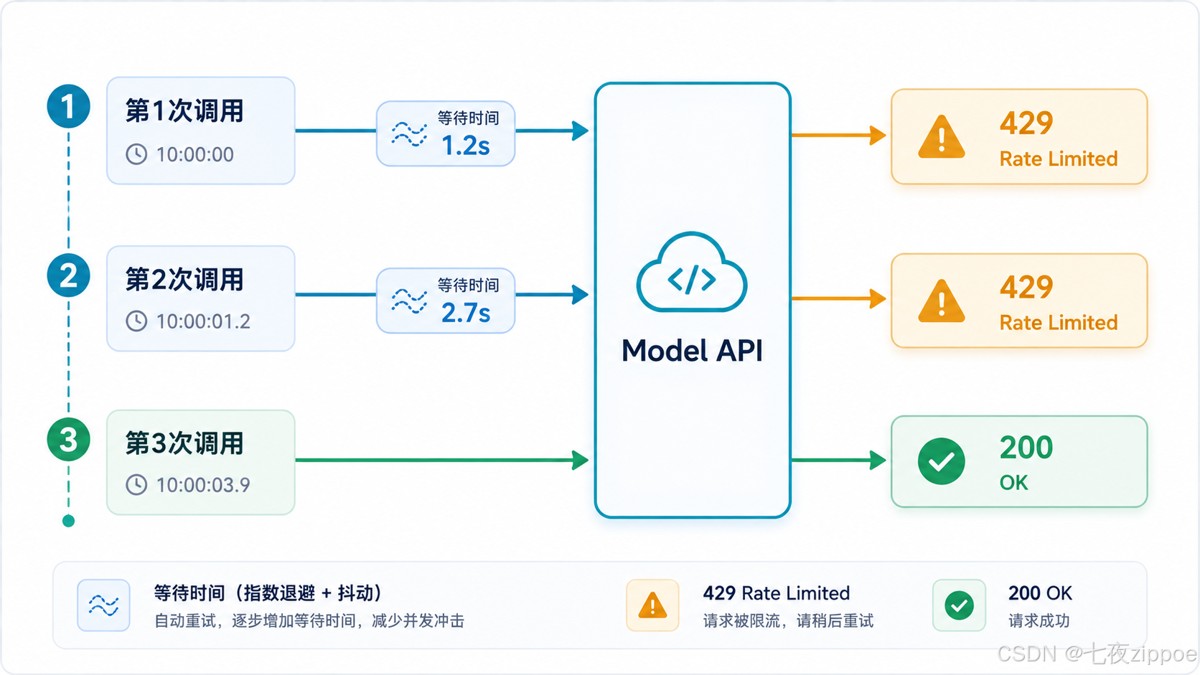
图 2:指数退避与抖动在 429 限流场景下的请求时序示意
五、优雅降级模式:Plan B 是标配
重试解决的是暂时性错误,但有些错误重试无法解决:模型服务挂了、工具彻底不可用。这时你需要降级,用一个可接受的替代方案维持核心功能。
5.1 模型降级链
当主模型不可用时,OpenClaw 会按预设链路自动切换到备用模型。一个典型的降级链是:首选 gpt-4o;当错误率超过 30% 或 P95 延迟超过 10 秒时,切换到 gpt-4o-mini;如果问题持续,再尝试 claude-3-5-haiku;最后由本地部署的 qwen2.5-7b 兜底。每一级都有明确的触发条件,例如连续 3 次失败、all_remote_unavailable 等。
设计降级链时要注意四个因素:一是能力匹配,备用模型能否完成主模型的大部分任务;二是延迟差异,降级后响应速度是否仍可接受;三是成本差异,避免从便宜模型降级到更贵模型;四是上下文兼容,切换模型时对话历史能否无缝迁移。配置化设计让运维人员无需改代码即可调整策略,最后一级本地模型兜底保证极端情况下核心对话仍然可用。
5.2 工具降级与功能降级
工具降级的思路是:核心工具不可用时,用次优方案替代。功能降级则是主动关闭非核心功能,把资源留给最重要的任务。
| 主工具 | 降级方案 | 降级影响 |
|---|---|---|
| 实时搜索 API | 本地缓存 + 知识库检索 | 信息可能不是最新 |
| 飞书文档 API | 本地 Markdown 备份 | 格式可能丢失 |
| OCR 识别服务 | 纯文本提取 | 无法识别图片文字 |
| TTS 语音合成 | 纯文本回复 | 丢失语音交互能力 |
from dataclasses import dataclass, field
from typing import Any, Callable, Optional
from enum import Enum
class ToolStatus(Enum):
    HEALTHY = "healthy"
    DEGRADED = "degraded"
    UNAVAILABLE = "unavailable"
# 工具三级降级:主工具 -> 降级方案 -> 缓存
@dataclass
class ToolWithFallback:
    """带三级降级的工具包装器:主工具 → 降级方案 → 缓存。"""
    name: str
    primary_fn: Callable
    fallback_fn: Optional[Callable] = None
    cache_fn: Optional[Callable] = None
    status: ToolStatus = ToolStatus.HEALTHY
    failure_count: int = 0
    degradation_threshold: int = 3
    async def execute(self, **kwargs) -> Any:
        if self.status == ToolStatus.UNAVAILABLE:
            return await self._try_cache(**kwargs)
        try:
            result = await self.primary_fn(**kwargs)
            self.failure_count = 0
            self.status = ToolStatus.HEALTHY
            return result
        except Exception as e:
            self.failure_count += 1
            if self.failure_count >= self.degradation_threshold:
                self.status = ToolStatus.DEGRADED
            print(f"[Tool:{self.name}] 主工具失败: {e}")
        if self.status == ToolStatus.DEGRADED and self.fallback_fn:
            try:
                return await self.fallback_fn(**kwargs)
            except Exception as e:
                print(f"[Tool:{self.name}] 降级失败: {e}")
                self.status = ToolStatus.UNAVAILABLE
        return await self._try_cache(**kwargs)
    async def _try_cache(self, **kwargs) -> Any:
        if self.cache_fn:
            result = await self.cache_fn(**kwargs)
            if result:
                return result
        raise RuntimeError(f"工具 {self.name} 完全不可用,无可用缓存")
代码解释(100 字+):ToolWithFallback 实现了一个三级降级策略。主工具调用成功时状态回到 HEALTHY;连续失败达到阈值后进入 DEGRADED,切换到降级方案;降级方案也失败则标记为 UNAVAILABLE,后续请求直接走缓存。这种设计把“重试无效后的兜底”和“自动恢复”都封装在工具层,调用方无需关心内部状态。
5.3 功能降级状态机
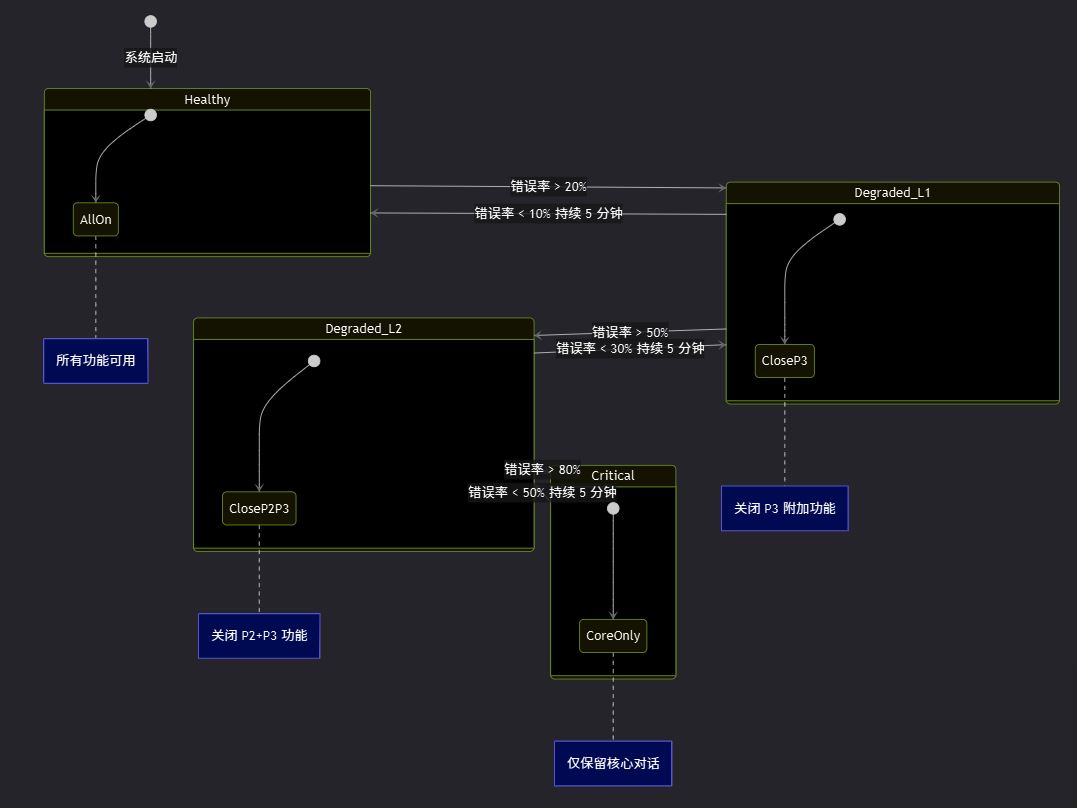
当系统压力过大时,按优先级关闭非核心功能。状态转换可以用 Mermaid 状态图表达:
六、Circuit Breaker 熔断器:别再去撞墙了
熔断器是分布式系统中的经典保护模式。它的核心思想是:如果一个服务持续失败,就不要继续请求它,等服务恢复后再试探性地重新连接。
6.1 三种状态
熔断器有三个状态:
- CLOSED(关闭):正常状态,请求正常通过。
- OPEN(打开):熔断状态,请求直接走降级,不发送到下游。
- HALF_OPEN(半开):试探状态,允许少量请求通过,测试下游是否恢复。
6.2 完整实现
import time, threading
from enum import Enum
from dataclasses import dataclass, field
class CircuitState(Enum):
    CLOSED = "closed"; OPEN = "open"; HALF_OPEN = "half_open"
@dataclass
class CircuitBreaker:
    name: str
    failure_threshold: int = 5      # 触发熔断的连续失败次数
    recovery_timeout: float = 30.0  # OPEN 后等待多久进入 HALF_OPEN
    half_open_max_calls: int = 3    # 半开状态允许的试探请求数
    success_threshold: int = 2      # 半开状态连续成功多少次恢复 CLOSED
    state: CircuitState = CircuitState.CLOSED
    failure_count: int = 0
    success_count: int = 0
    half_open_calls: int = 0
    last_failure_time: float = 0.0
    _lock: threading.Lock = field(default_factory=threading.Lock)
    def can_execute(self) -> bool:
        with self._lock:
            if self.state == CircuitState.CLOSED: return True
            if self.state == CircuitState.OPEN:
                if time.time() - self.last_failure_time >= self.recovery_timeout:
                    self.state, self.half_open_calls, self.success_count = CircuitState.HALF_OPEN, 0, 0
                    return True
                return False
            if self.half_open_calls < self.half_open_max_calls:
                self.half_open_calls += 1
                return True
            return False
    def record(self, success: bool):
        with self._lock:
            if success:
                if self.state == CircuitState.HALF_OPEN:
                    self.success_count += 1
                    if self.success_count >= self.success_threshold:
                        self.state, self.failure_count = CircuitState.CLOSED, 0
                else:
                    self.failure_count = 0
            else:
                self.failure_count += 1
                self.last_failure_time = time.time()
                self.state = CircuitState.OPEN
代码解释(100 字+):CircuitBreaker 通过 _lock 保证线程安全,核心逻辑在 can_execute() 和 record() 两个方法中。调用方在请求前先执行 can_execute():CLOSED 时放行;OPEN 时检查是否超过 recovery_timeout,若超过则进入 HALF_OPEN 并允许少量试探;HALF_OPEN 中连续成功达到 success_threshold 后恢复 CLOSED。请求结束后调用 record(success=True/False) 更新状态。参数注释直接标注了每个阈值的语义,便于根据服务稳定性调参。
6.3 熔断器参数调优
| 参数 | OpenAI API | 搜索工具 | 飞书 API | 调优思路 |
|---|---|---|---|---|
| failure_threshold | 5 | 3 | 10 | 越关键、越不稳定的服务越要早熔断 |
| recovery_timeout | 30s | 60s | 15s | 越快恢复的服务等待越短 |
| half_open_max_calls | 2 | 1 | 3 | 越不稳定的服务试探越少 |
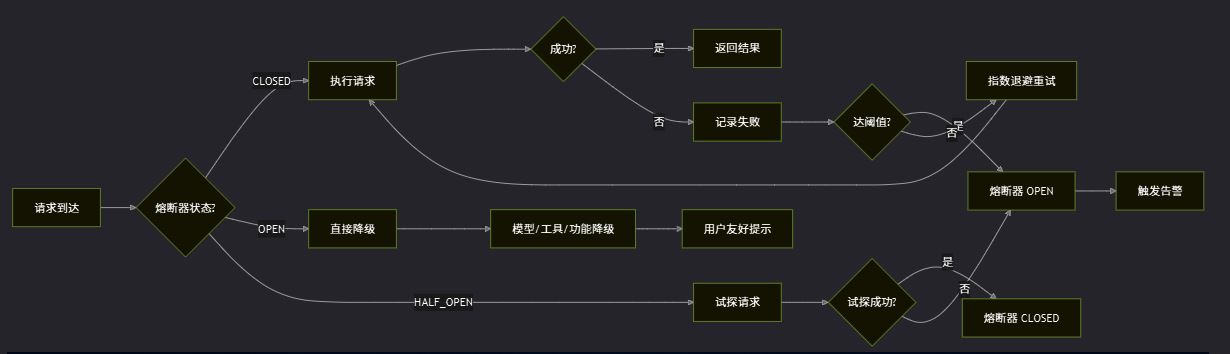
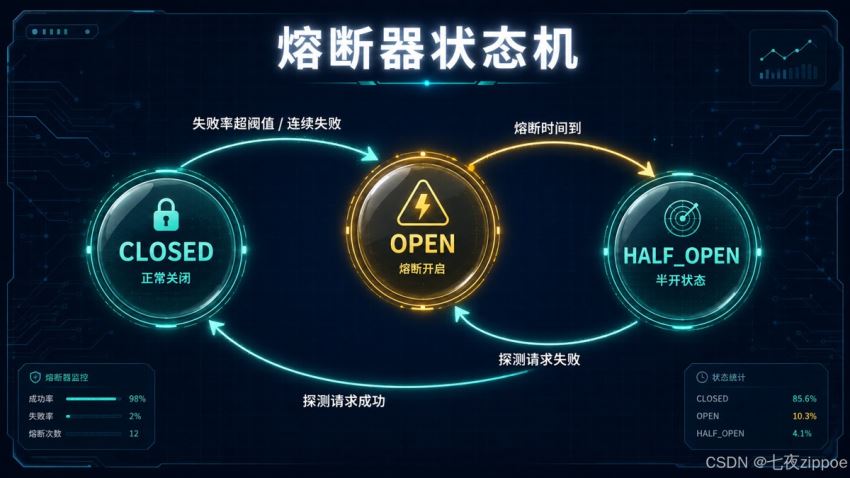
图 3:熔断器三种状态转换与告警联动机制示意图
七、错误日志与告警:出了问题你得第一时间知道
错误处理做好了还不够,你得知道它什么时候触发了。一个静默的降级比一个报错的系统更可怕——你都不知道自己的 Agent 已经在用降级模式工作了。
7.1 结构化日志
好的错误日志不是简单的 print,而是结构化、可检索的。推荐字段包括:时间戳、错误类型、错误码、组件名、消息、堆栈、重试次数、恢复动作、上下文。
import json
import time
import traceback
from dataclasses import dataclass, asdict, field
from typing import Optional
@dataclass
class ErrorLog:
    """结构化错误日志,便于后续检索与聚合分析。"""
    timestamp: float
    error_type: str
    error_code: str
    component: str
    message: str
    stack_trace: Optional[str] = None
    retry_count: int = 0
    recovery_action: str = ""
    recovery_result: str = ""
    context: dict = field(default_factory=dict)
    def to_json(self) -> str:
        return json.dumps(asdict(self), ensure_ascii=False, indent=2)
def log_error(
    error: Exception,
    error_type: str,
    component: str,
    recovery_action: str = "",
    retry_count: int = 0,
    **context
):
    log = ErrorLog(
        timestamp=time.time(),
        error_type=error_type,
        error_code=getattr(error, "code", type(error).__name__),
        component=component,
        message=str(error),
        stack_trace=traceback.format_exc(),
        retry_count=retry_count,
        recovery_action=recovery_action,
        context=context,
    )
    print(log.to_json())
    return log
代码解释(100 字+):ErrorLog 把错误事件统一成结构化 JSON,包含错误类型、组件、恢复动作、重试次数等维度。这样的日志可以被 ELK、Splunk 或云端日志服务直接索引。例如查询 component:openai_api AND error_code:429 AND recovery_action:degrade,就能快速定位模型限流触发降级的频次和趋势,为后续调参提供数据依据。
7.2 分级告警配置
不是所有错误都需要立即通知。合理的告警分级可以避免“狼来了”效应。建议把告警至少分为四级:
- critical:熔断器打开,意味着某个下游服务可能整体不可用,必须立即通知。
- high:模型降级或工具降级,系统仍在运行但质量可能下降,需要 5 分钟内响应。
- medium:连续失败超过阈值,可能是暂时性问题,关注即可。
- low:普通重试成功,只记录日志,不打扰值班人员。
每条告警规则都要带 cooldown 冷却时间。例如 critical 级别冷却 60 秒,high 级别 300 秒,medium 级别 600 秒。这样可以避免同一故障在恢复前反复轰炸。Webhook 地址建议通过环境变量注入,避免把敏感链接硬编码到仓库中。
八、用户友好的错误提示:别把堆栈甩给用户
技术层面的错误处理做好了,用户体验层面也要跟上。当错误发生时,用户看到的不应该是一段晦涩的堆栈,而是一段清晰、友好、有指引的信息。
8.1 提示设计原则
好的错误提示应该做到:说人话、说原因、说方案、别说太多。不要暴露内部实现细节。
| 场景 | 糟糕的提示 | 友好的提示 |
|---|---|---|
| 模型限流 | Error: HTTP 429 Too Many Requests | 当前使用人数较多,请稍后再试 |
| 工具超时 | TimeoutError: search_tool exceeded 30000ms | 搜索服务暂时响应较慢,正在使用缓存数据为你回答 |
| 上下文超长 | ValueError: context_length_exceeded | 对话内容较长,我需要清理部分历史才能继续 |
| 权限不足 | PermissionDenied: user ou_xxx has no access | 你没有访问该文档的权限,请联系管理员申请 |
8.2 模板化提示
用模板管理错误提示,可以让文案与业务代码解耦,方便统一维护和多语言扩展。一个模板通常包含三层:错误类型键、语言版本、恢复动作文案。例如 model_rate_limited 在中文环境下,retrying 动作对应“当前使用人数较多,正在自动重试……”,fallback 动作对应“当前使用人数较多,已切换到备用模型,可能回复速度稍慢”。
模板化还便于 A/B 测试不同话术的效果。你可以把同一错误的两套提示随机分配给不同用户,观察用户满意度、重试率、会话放弃率等指标,再决定哪套文案胜出。对于跨国团队,模板文件可以独立交给产品经理或本地化团队维护,不需要开发人员逐行改代码。
九、完整配置实战:把策略串成一套体系
把前面的重试、降级、熔断、告警整合成一份可落地的 OpenClaw 配置:
# openclaw-error-handling.yaml
retry:
  default:
    max_retries: 3
    base_delay: 1.0
    max_delay: 60.0
    jitter: 0.4
    retryable_errors: ["429", "503", "timeout", "connection_reset"]
  overrides:
    openai_api: { max_retries: 5, base_delay: 2.0, jitter: 0.5 }
    search_tool: { max_retries: 2, base_delay: 0.5, jitter: 0.3 }
model_fallback:
  chain:
    - model: gpt-4o
      trigger: "error_rate > 0.3 OR latency_p95 > 10s"
    - model: gpt-4o-mini
      trigger: "error_rate > 0.5 OR latency_p95 > 15s"
    - model: claude-3-5-haiku
      trigger: "consecutive_errors >= 5"
    - model: local-qwen2.5-7b
      trigger: "all_remote_unavailable"
circuit_breakers:
  openai_api: { failure_threshold: 5, recovery_timeout: 30, half_open_max_calls: 2 }
  search_tool: { failure_threshold: 3, recovery_timeout: 60, half_open_max_calls: 1 }
  feishu_api: { failure_threshold: 10, recovery_timeout: 15, half_open_max_calls: 3 }
feature_degradation:
  levels:
    - name: full
      max_priority: 3
      description: "所有功能可用"
    - name: reduced
      max_priority: 1
      trigger: "system_load > 0.8"
      description: "关闭语音和图片生成"
    - name: minimal
      max_priority: 0
      trigger: "system_load > 0.95 OR error_rate > 0.5"
      description: "仅保留核心对话"
alerts:
  feishu_webhook: "${FEISHU_ALERT_WEBHOOK}"
  rules:
    - condition: "circuit_state == 'open'"
      severity: critical
      cooldown: 60
    - condition: "model_degraded"
      severity: high
      cooldown: 300
    - condition: "consecutive_failures >= 5"
      severity: medium
      cooldown: 600
代码解释(100 字+):这份 YAML 把重试默认值与组件级覆盖、模型降级链、熔断器参数、功能降级级别、告警规则整合到一个文件里。overrides 让不同外部服务拥有不同的重试策略;feature_degradation 按系统负载自动关闭非核心功能;告警规则带 cooldown 避免轰炸。你可以直接把它作为 OpenClaw 项目的错误处理基线配置,再根据实际运行数据微调阈值。
十、效果验证与调参建议
光讲理论不够,你需要在真实环境中验证错误处理策略的效果,并根据数据持续调参。
10.1 关键观测指标
建议至少监控以下指标:
- 错误率(error_rate):单位时间内失败请求占比,判断是否触发降级。
- P95/P99 延迟: tail 延迟更能反映用户真实体验。
- 重试成功率:重试后成功比例,验证退避策略是否合理。
- 降级触发频率:模型/工具/功能降级分别触发了多少次。
- 熔断器状态持续时间:OPEN 状态持续了多久,判断恢复速度。
10.2 压测前后对比
下面是一组在某内部 OpenClaw 助手上优化前后的参考数据(业务峰值为 100 QPS):
| 指标 | 优化前 | 优化后 | 说明 |
|---|---|---|---|
| 整体错误率 | 8.5% | 1.2% | 重试 + 降级覆盖了大部分暂时性失败 |
| P95 响应时间 | 4.2s | 1.8s | 熔断器避免了对已故障服务的无效等待 |
| 服务完全不可用次数/天 | 12 | 0 | 本地模型兜底保证核心对话可用 |
| 用户投诉量/周 | 23 | 4 | 用户友好提示降低了焦虑感 |
| 告警误报率 | 35% | 8% | cooldown 与分级规则减少了噪音 |
这组数据表明,系统化的错误处理不仅能提升稳定性,还能显著改善用户体验和运维效率。当然,具体数字会因业务场景不同而有差异,关键是建立可量化的反馈闭环。
10.3 调参建议
- 重试次数:先从 3 次起步,观察重试成功率;如果成功率低于 30%,说明问题不是暂时性的,应减少重试、加快降级。
- 抖动系数:0.3 适合低并发,0.5 适合高并发;超过 0.7 会让延迟变得不可预测。
- 熔断阈值:稳定服务
failure_threshold可设 5-10,搜索等不稳定服务建议 3。 - 恢复超时:生产环境建议至少 30 秒,给服务足够的恢复窗口;太短会导致频繁半开试探。
十一、适用边界与风险提示
错误处理虽然重要,但也不是越多越好。以下几种情况需要谨慎:
- 不要为了容错而隐藏真正的问题。 过度降级可能让系统长期处于亚健康状态,而你却浑然不觉。必须配合日志和告警,确保每次降级都可观测。
- 不要对所有错误都重试。 400 参数错误、401 鉴权失败重试只会浪费 Token 和时间。
retryable_errors必须精确配置。 - 不要过度压缩用户提示。 提示信息要真实反映当前状态,如果隐瞒“已切换到精简模式”,用户可能会对回答质量产生不切实际的期待。
- 熔断器参数不能一刀切。 不同服务的恢复速度和稳定性差异很大,
recovery_timeout和failure_threshold需要根据历史数据动态调整。
如果你的 OpenClaw 每天只有几十次调用,或者所有外部服务都高度稳定,那么维护一套复杂容错系统的边际收益可能很低。此时选择恰到好处的默认重试 + 简单降级,反而更务实。
十二、总结
错误处理是 AI Agent 系统从“能用”到“好用”的关键分水岭。一个没有错误处理的 Agent,就像一辆没有刹车的车——跑得再快也不安全。
回顾本文的核心要点:
错误分类是基础。模型错误、工具错误、网络错误、业务错误,每种错误的可重试性和恢复策略都不同。分类错了,后续方案就是空中楼阁。
重试是第一道防线。指数退避加抖动是生产环境标配,固定间隔重试只适合低并发脚本。记住,粗暴重试比不重试更危险。
优雅降级是安全网。模型降级、工具降级、功能降级三层保护,确保核心功能始终可用。降级的目标不是完美,而是守住用户最需要的体验。
熔断器是保险丝。当服务持续失败时自动断开,避免资源浪费和雪崩;恢复后通过 HALF_OPEN 试探性重新接入。
告警是眼睛。熔断触发、模型降级、连续失败这类关键事件必须第一时间通知到人,否则错误处理就形同虚设。
用户提示是门面。把晦涩的技术错误翻译成用户能理解的语言,是提升 Agent 产品体验的最后一步。
把这些机制串起来,你的 OpenClaw Agent 就能在风雨中稳步前行。错误不是意外,而是常态——越早接受这一点,系统就越早变得健壮。
思考题
- 如果 OpenClaw 的所有外部模型服务同时不可用,你会如何设计本地降级方案来保证 Agent 基本可用? 提示:考虑本地模型、离线知识库和预设回复模板的组合。
- 熔断器的
recovery_timeout设得太大或太小分别会有什么问题? 如果一个服务每 5 分钟出一次问题、持续 30 秒,你会怎么调参? - 在多 Agent 协作场景中,一个 Agent 的熔断器触发可能如何影响其他 Agent? 你会怎么设计跨 Agent 的错误传播和隔离机制?
以上就是OpenClaw错误处理实战:优雅降级、重试机制与熔断器设计的详细内容,更多关于OpenClaw错误处理实战的资料请关注脚本之家其它相关文章!
相关文章
OpenClaw报错信息怎么看?OpenClaw中五大常见错误排查与解决方法
别再被OpenClaw报错吓退了,遇到满屏红色别慌,我来教你读懂这些提示,快速解决问题,本文拆解了网关启动失败、API密钥无效、端口占用等5大类常见错误,总结出“三问排错法”,2026-07-11 这篇文章详细解析了403 Forbidden和503 Service Unavailableable两种HTTP错误码的常见原因,并并提供提供了OpenClaw日志分析和自动诊断工具的使用方法,帮助开发者系统和解决2026-06-05
OpenClaw网关启动失败:配置文件权限错误的排查与修复指南
某天启动 OpenClaw(MyClaw.app)时,网关无法正常启动,应用界面一直处于“连接中”或直接报错,查看日志发现出现配置文件权限错误,所以本文给大家介绍了OpenClaw网关启动2026-05-12 本文介绍了OpenClaw常见报错的核心概念、技术原理、应用场景和最佳实践,包括环境准备、基础示例、进阶示例、常见问题及解决方案,并提供了性能优化和安全注意事项,同时,还给2026-05-06
OpenClaw开发Agent Skills最常见的12种错误和对应的解决方案
作者记录了使用 OpenClaw 开发 Agent Skills 时踩过的 12 个常见报错坑,并整理了完整解决方案,适合正在使用 OpenClaw 遇到问题的开发者参考2026-04-07
openclaw搭建报错纠正篇(错误结果 + 原因 + 修复办法)
OpenClaw是一个功能强大但上手简单的工具,不要害怕尝试和犯错,在实践中学习是最快的方式,这篇文章主要介绍了openclaw搭建报错纠正篇的相关资料,文中通过代码介绍的非常详细2026-04-03
OpenClaw 安装、运行、使用常见错误总结与解决方案(含Windows/macOS/Linux 全平台)
这篇文章给大家介绍OpenClaw 安装、运行、使用常见错误总结与解决方案,本文按阶段分类,提供可操作的解决方案,涵盖 Windows/macOS/Linux 全平台,感兴趣的朋友跟随小编一2026-03-27 本文介绍了在星图GPU平台上自动化部署ollama QwQ-32B镜像的排错指南,帮助用户解决模型对接OpenClaw时的常见问题,文中通过示例代码介绍的非常详细,对大家的学习或者工作具2026-03-27
最新评论